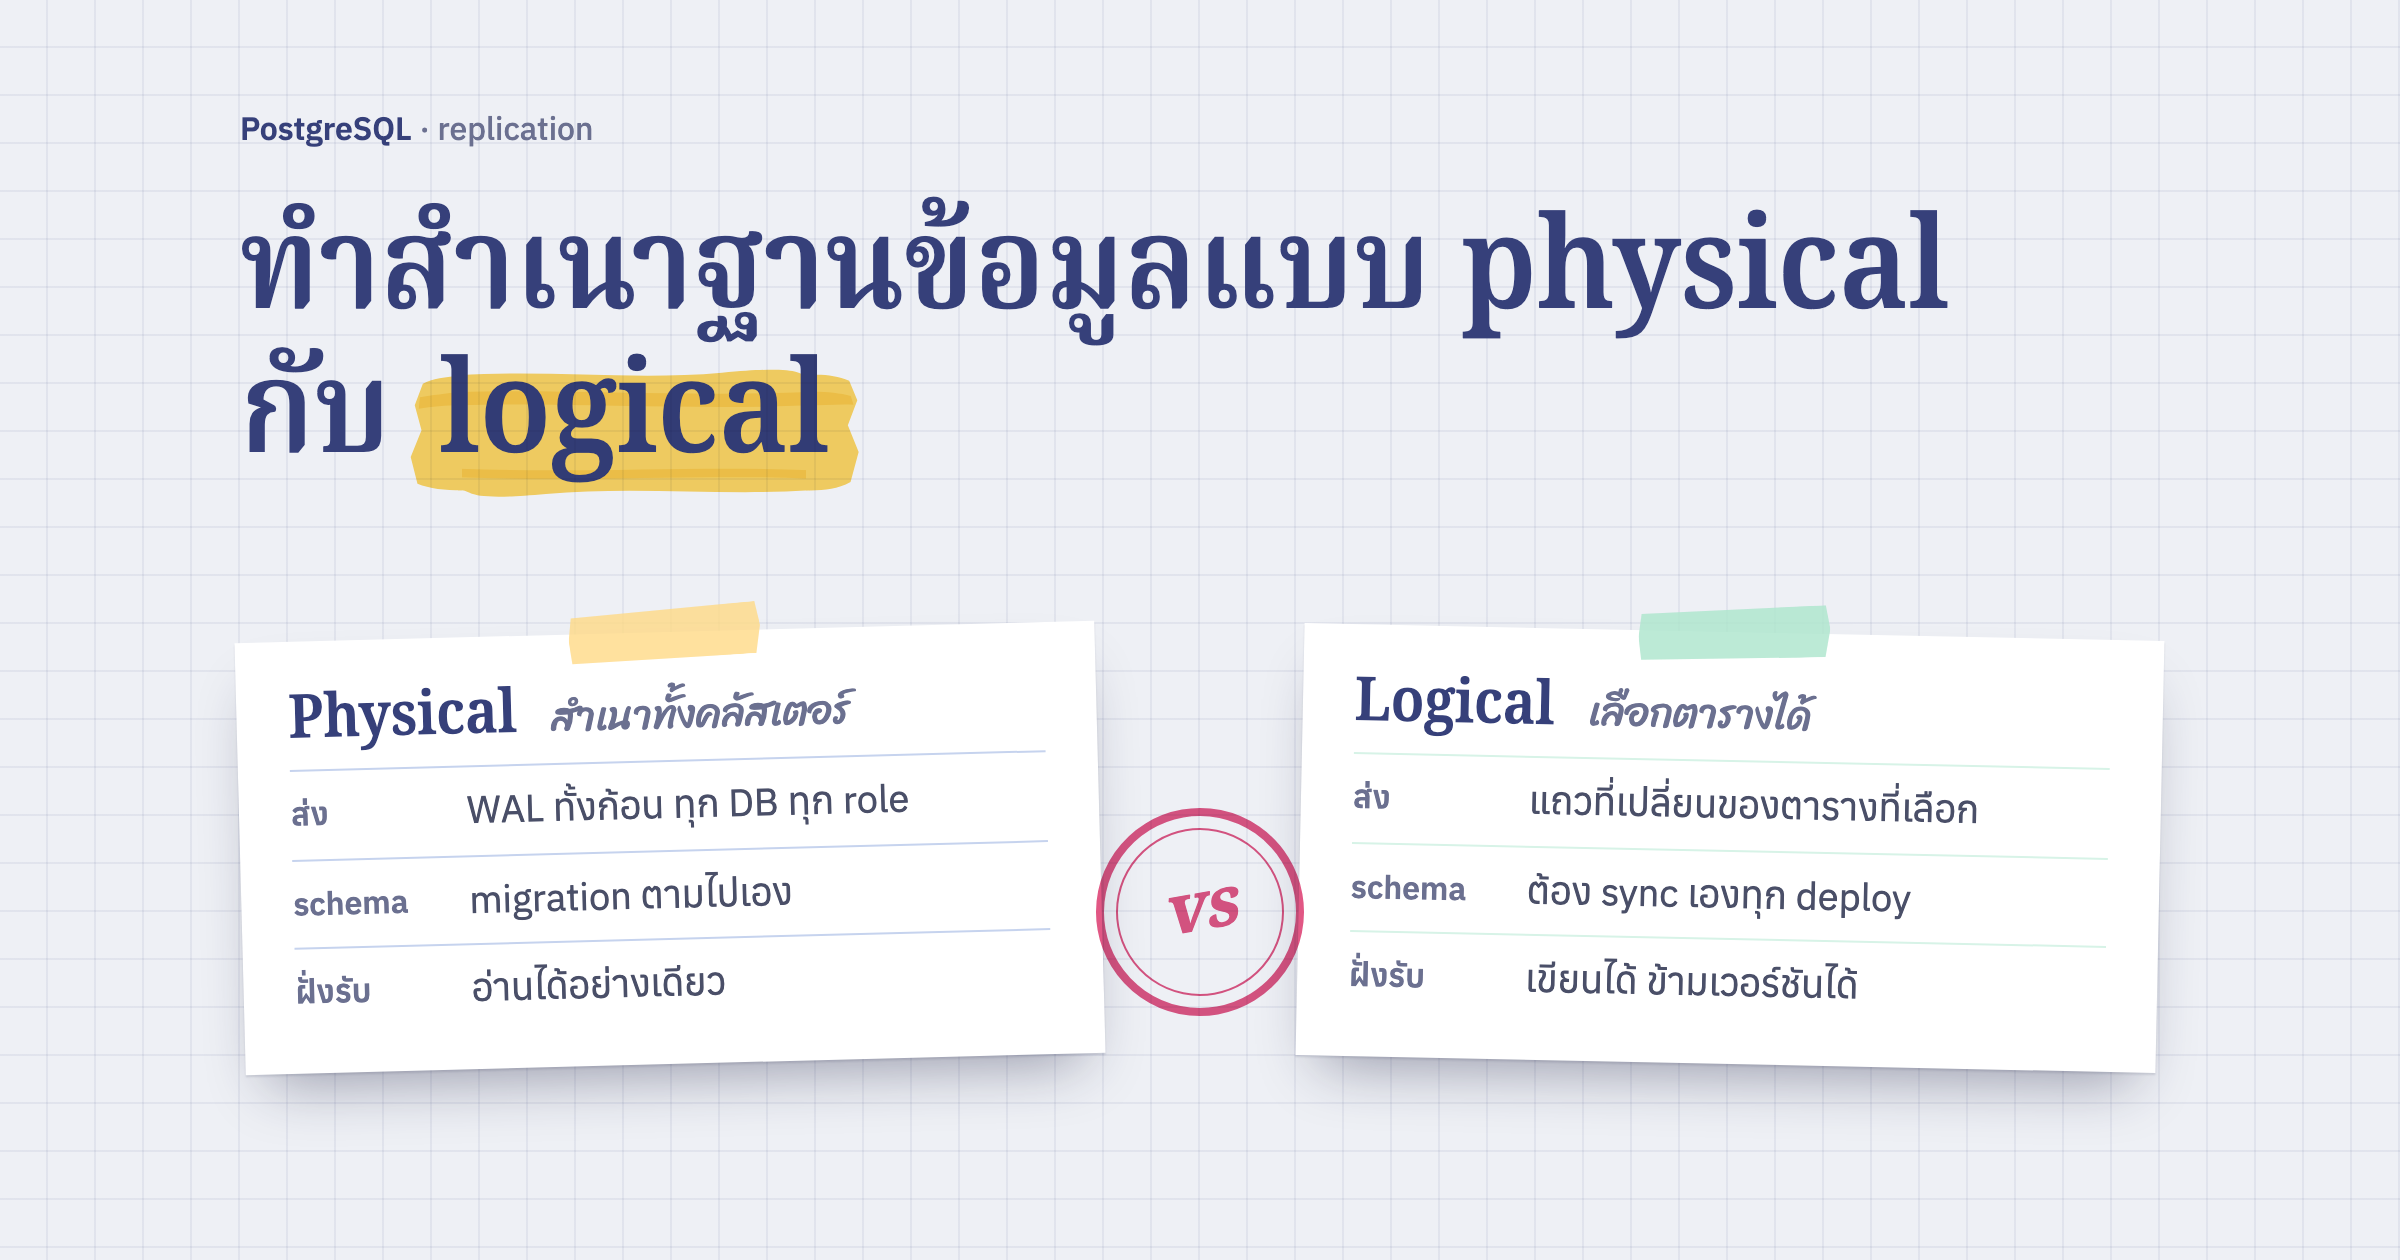
แอป Laravel ทั่วไปใช้ฐานข้อมูลเครื่องเดียว ถ้ายังเป็นแบบนั้นอยู่ ฟีเจอร์หลักของรุ่นนี้ยังไม่ต้องใช้ ข้ามไปอ่านเรื่องเล็ก ๆ ท้ายโพสต์ได้เลย แต่ถ้าเริ่มทำสำเนาฐานข้อมูลไว้อีกเครื่อง อย่างที่เล่าไว้ในโพสต์เรื่อง PostgreSQL replication แล้วคิดจะให้แอปอ่านจากเครื่องนั้นด้วย เรื่องนี้จะเจอแน่
ผู้ใช้เห็นข้อมูลเก่าเพราะ replica ตามหลังเครื่องหลักอยู่เสมอ
replica รับการเปลี่ยนแปลงจากเครื่องหลักแบบ async ปกติตามหลังไม่ถึงวินาที แต่ช่วงที่เครื่องหลักยุ่งหรือมี query หนักรันบน replica ก็อาจห่างเป็นหลายวินาที ลองนึกถึงฟอร์มแก้โปรไฟล์
- ผู้ใช้กดบันทึก request นี้
UPDATEลงเครื่องหลัก แล้ว redirect กลับไปหน้าโปรไฟล์ - request ถัดมาอ่านโปรไฟล์จาก replica ที่ยังไม่ได้รับ
UPDATEนั้น - ผู้ใช้เห็นชื่อเดิม คิดว่าบันทึกไม่ติด แล้วกดบันทึกซ้ำ
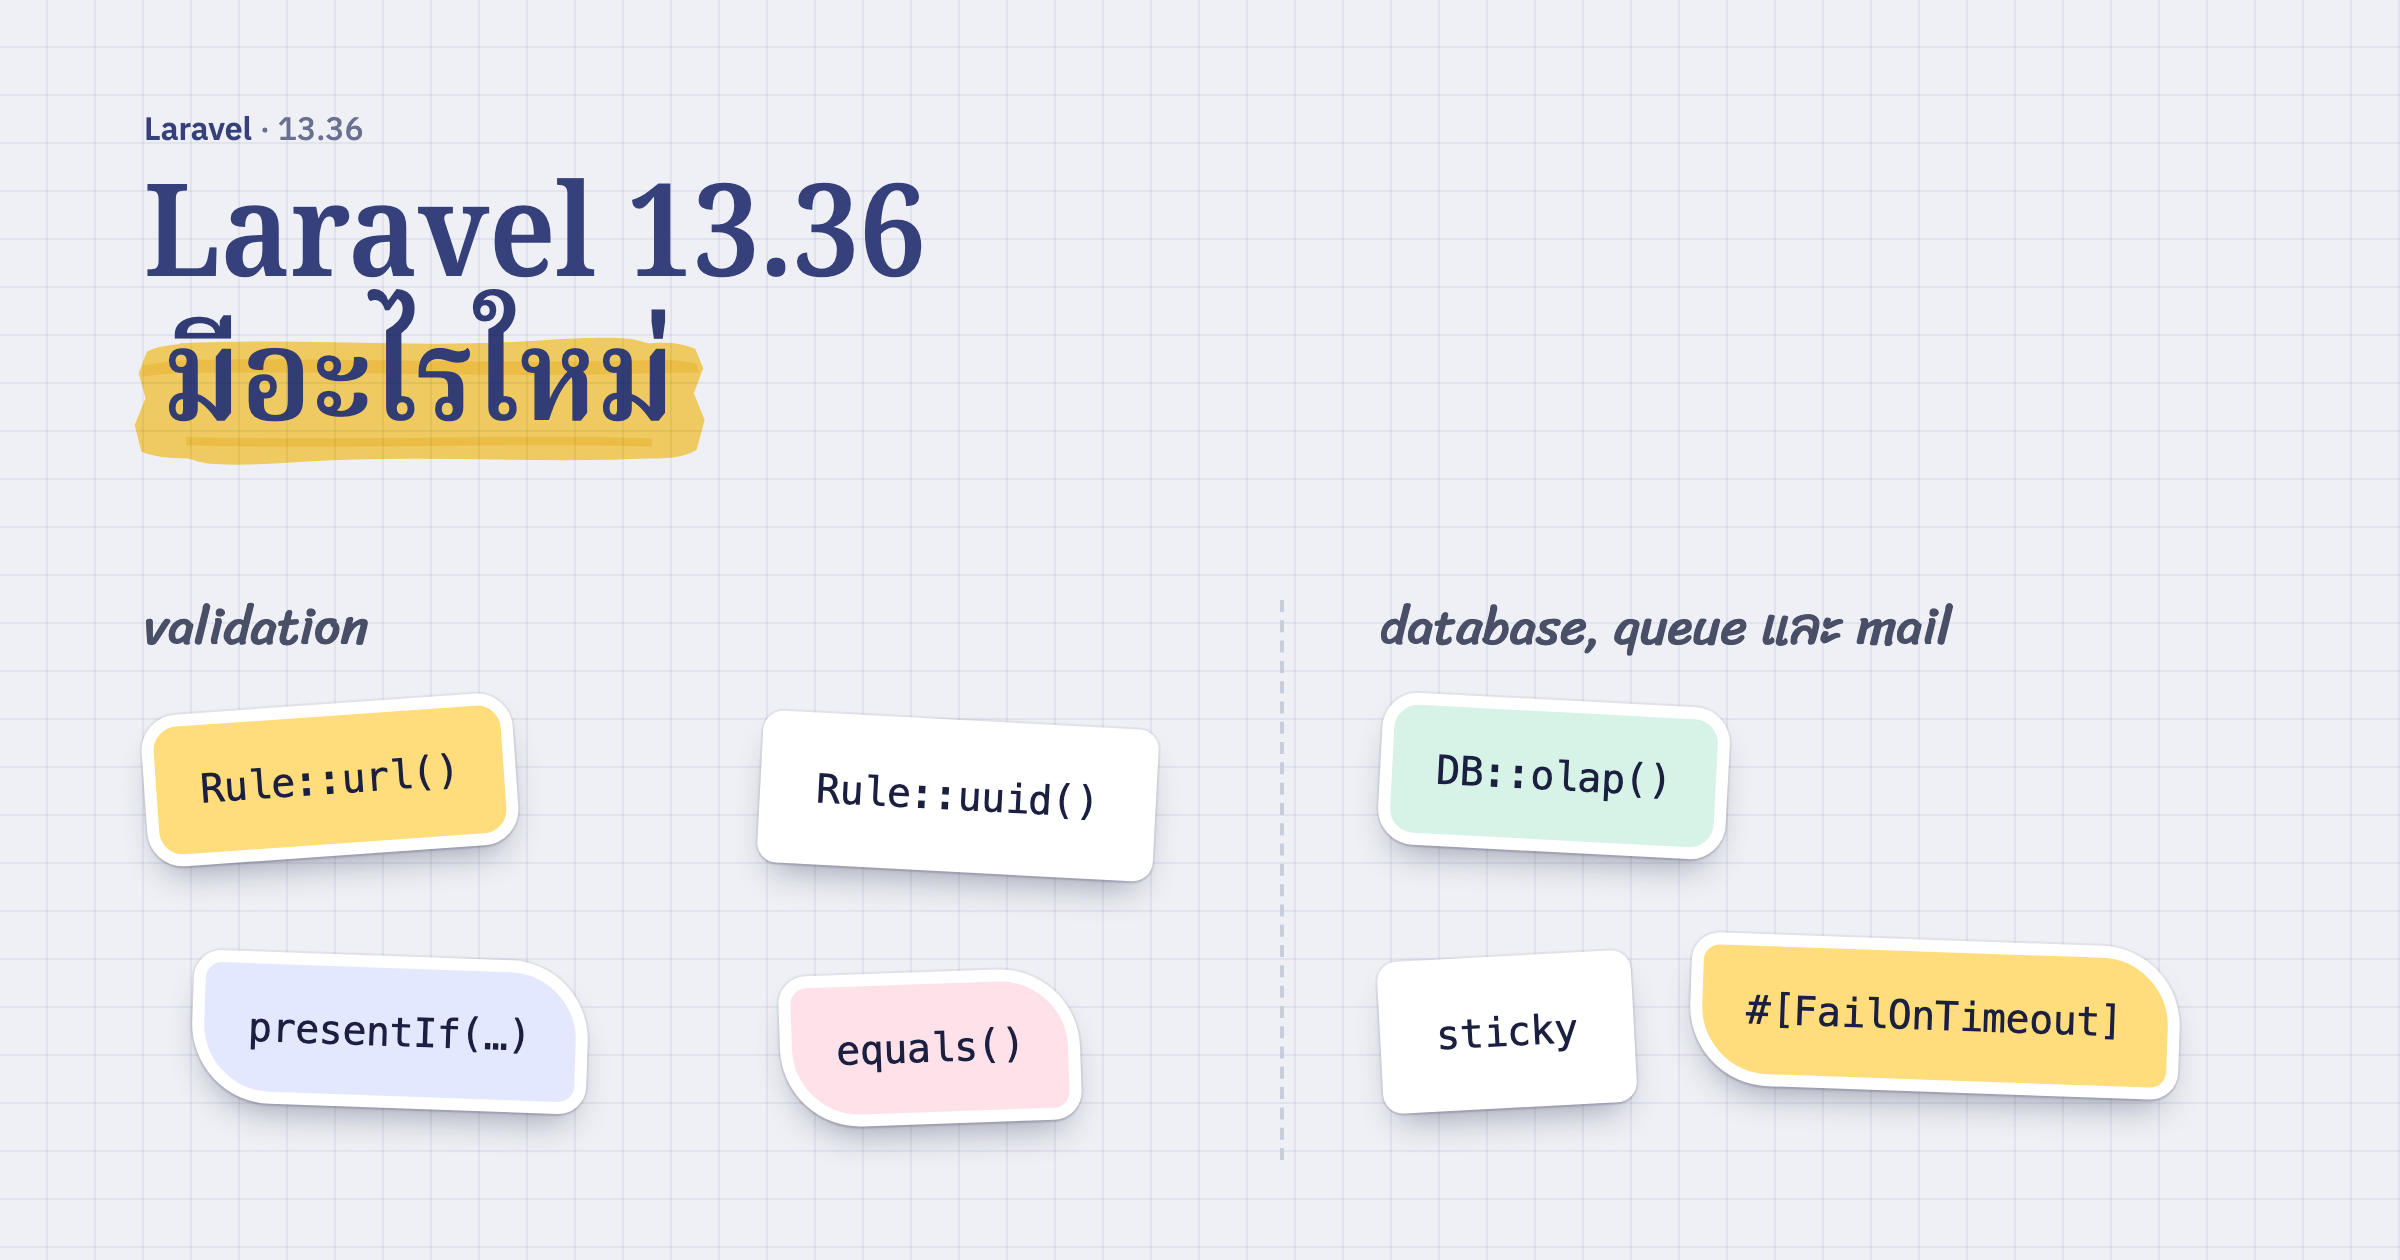
ตัวเลือก sticky ใน config/database.php ที่มีมานานช่วยได้แค่ใน request เดียวกัน หลังเขียนครั้งแรก การอ่านที่เหลือใน request นั้นจะไปเครื่องหลัก แต่ข้อ 2 เป็น request ใหม่ sticky จึงไม่ช่วย (ส่วนเรื่อง sticky ใน queue worker เขียนไว้ในLaravel 13.36)
'mysql' => [
    'driver' => 'mysql',
    'read' => [
        'host' => [env('DB_READ_HOST', '10.0.0.3')],
    ],
    'write' => [
        'host' => [env('DB_HOST', '10.0.0.2')],
    ],
    'sticky' => true,
    // ...
],
ที่ผ่านมาเราก็มักแก้ด้วยการส่งข้อมูลที่เพิ่งบันทึกไปกับ flash session หรือสั่งให้หน้านั้นอ่านจากเครื่องหลักเองทีละ query ก็ใช้ได้นะ แต่ต้องตามใส่ทุกหน้าที่มีฟอร์ม
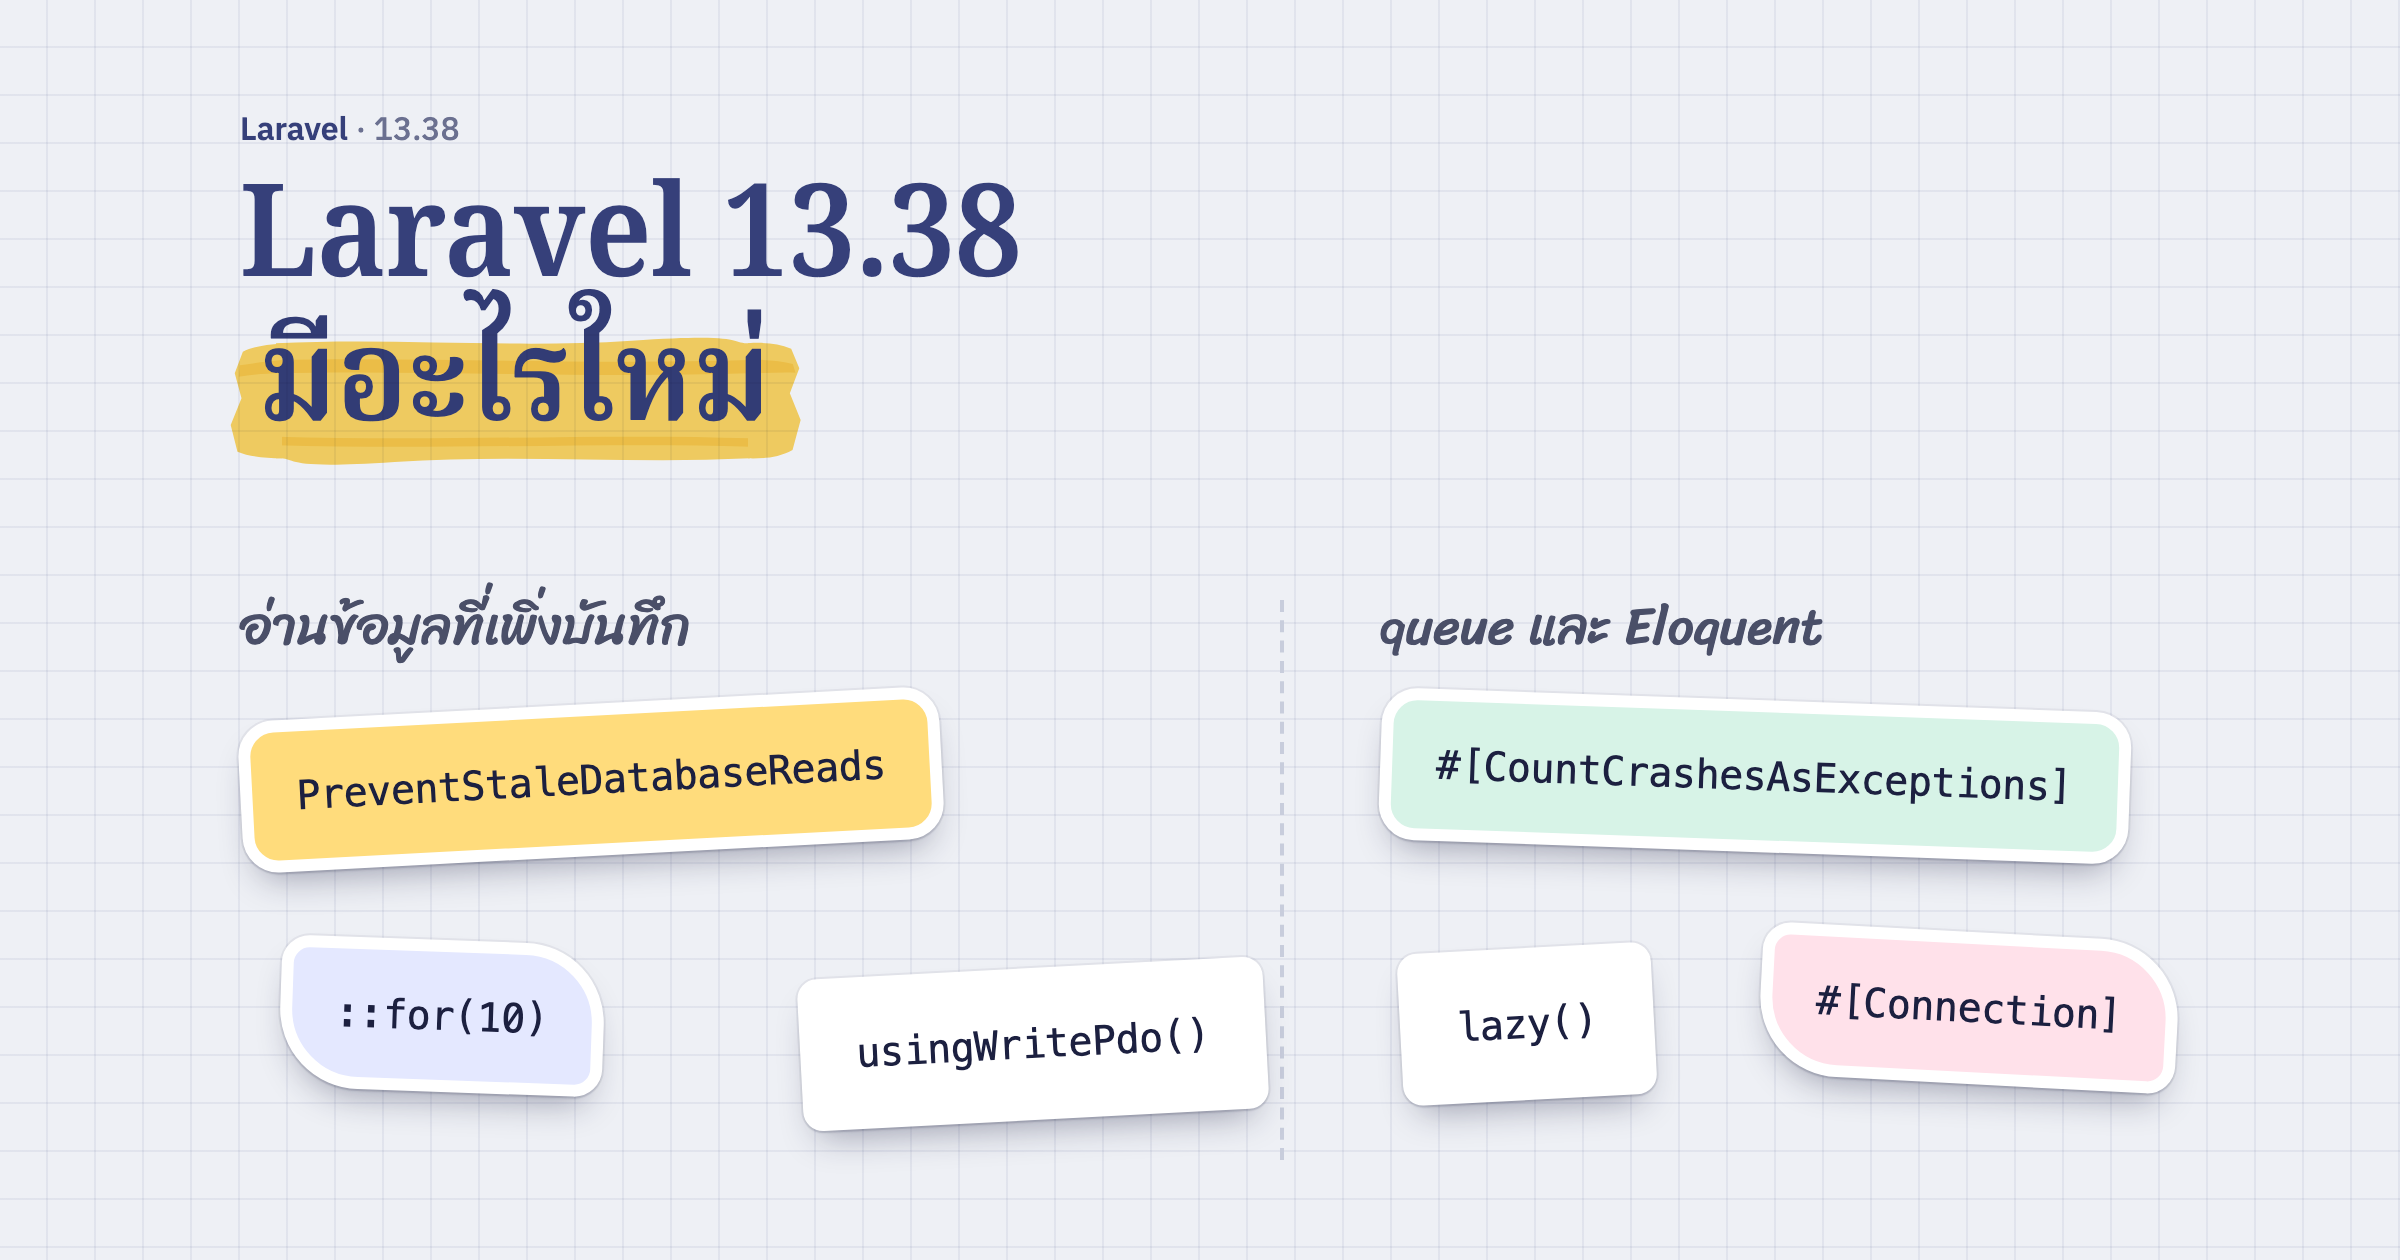
PreventStaleDatabaseReads จำไว้ใน session ว่าผู้ใช้เพิ่งเขียนข้อมูล
Jack Bayliss เพิ่ม middleware ที่ทำงานแบบนี้
- จบ request ไหนที่มีการเขียนลง connection หลักของแอป middleware จะเก็บเวลาไว้ใน session
- request ถัดไปของ session เดียวกัน ถ้ายังอยู่ในสองวินาทีนับจากเวลานั้น การอ่านทั้งหมดจะไปเครื่องหลัก
- พ้นสองวินาทีแล้ว ก็กลับไปอ่านจาก replica ตามปกติ
เปิดใช้ด้วยการต่อท้ายกลุ่ม web ใน bootstrap/app.php middleware นี้ต้องรันหลัง StartSession เพราะอ่านเขียน session ซึ่งต่อท้ายกลุ่ม web ก็อยู่หลังอยู่แล้ว
use Illuminate\Foundation\Configuration\Middleware;
use Illuminate\Foundation\Http\Middleware\PreventStaleDatabaseReads;

->withMiddleware(function (Middleware $middleware): void {
    $middleware->web(append: [
        PreventStaleDatabaseReads::class,
    ]);
})
ถ้า replica ของเราตามหลังนานกว่าสองวินาทีบ่อย ๆ ขยายเวลาได้ด้วย for() จะใส่ทั้งแอปหรือเฉพาะกลุ่ม route ก็ได้
Route::middleware(PreventStaleDatabaseReads::for(10))->group(function () {
    Route::get('/posts/{post}', [PostController::class, 'show']);
    Route::put('/posts/{post}', [PostController::class, 'update']);
});
ตัวเลขนี้ควรมาจากที่ replica ตามหลังจริง ไม่ใช่เดา บน PostgreSQL ดูได้จาก replay_lag ใน pg_stat_replication ตามที่จดไว้ในคำสั่ง PostgreSQL replication ที่ใช้บ่อย ส่วน MySQL ดูจาก Seconds_Behind_Source ใน SHOW REPLICA STATUS
middleware นี้กันได้เฉพาะคนที่เขียนเอง
docs ของ Laravel กับ PR บอกขอบเขตไว้ชัด
- กันให้เฉพาะ session ที่เขียน แอดมินกดอนุมัติคำสั่งซื้อ ตัวแอดมินเห็นสถานะใหม่ทันที แต่ลูกค้าที่เปิดหน้าคำสั่งซื้ออยู่ในวินาทีเดียวกันยังอาจเห็นสถานะเดิมจาก replica
- ต้องมี session API ที่ใช้ token ล้วนและไม่มี session จึงใช้ไม่ได้
- ดูแค่ connection หลัก ถ้าแอปมีหลาย connection ตัวอื่นไม่ได้รับผล
- request ที่ยิงพร้อมกันอาจเขียนเวลาทับกันใน session PR ยอมรับไว้ว่าเกิดได้แต่ไม่บ่อย
ข้อแรกสำคัญที่สุด หน้าที่ต้องถูกต้องสำหรับทุกคน อย่างสต็อกสินค้าตอนจะตัดยอด หรือยอดเงินคงเหลือ ไม่ควรอ่านจาก replica ตั้งแต่ต้น ใช้ DB::usingWritePdo() ในหัวข้อถัดไปกับโค้ดส่วนนั้นดีกว่า
DB::usingWritePdo() บังคับให้ทุก query ใน callback อ่านจากเครื่องหลัก
เดิมเรามี onWriteConnection() สั่งให้ query ตัวเดียวอ่านจากเครื่องหลัก แต่ relationship ที่โหลดต่อจาก model นั้นกลับไปอ่านจาก replica ตามเดิม usingWritePdo() จาก PR #62099 ครอบทุก query ใน callback ทั้ง query builder, Eloquent และ relationship
// เดิม ตัว user อ่านจากเครื่องหลัก แต่ posts ยังอ่านจาก replica
$user = User::onWriteConnection()->where('email', $email)->first();
$drafts = $user?->posts()->whereNull('published_at')->get();

// 13.38 ทุก query ใน callback อ่านจากเครื่องหลัก
$drafts = DB::usingWritePdo(fn () => User::query()
    ->where('email', $email)
    ->first()
    ?->posts()
    ->whereNull('published_at')
    ->get());
callback คืนค่าที่ return ออกมาให้เลย และพอ callback จบ connection ก็กลับไปอ่านจาก replica เหมือนเดิม แม้ข้างในจะโยน exception ก็ตาม
ของที่แก้เพิ่มใน 13.38
#[CountCrashesAsExceptions]ใช้กับ listener, mailable และ notification ที่เข้า queue ได้แล้ว เดิมใช้ได้แค่กับ job ถ้า worker ตายกลางทาง (หน่วยความจำหมดหรือโดน kill) Laravel จะนับครั้งนั้นรวมกับmaxExceptionsด้วย (PR #62048)- job จาก
Schedule::job()ที่ใช้ unique lock ไม่ค้างอีก เดิมถ้า push เข้า queue ไม่สำเร็จ lock ยังค้างอยู่ รอบถัดไป scheduler จึงข้าม job นั้นไปเรื่อย ๆ จนกว่า lock จะหมดอายุ (PR #62083) lazy()กับlazyById()คืนหน่วยความจำของก้อนก่อนหน้าก่อนดึงก้อนใหม่ คำสั่งที่วนข้อมูลเป็นแสนแถวจึงใช้หน่วยความจำสูงสุดน้อยลง (PR #62086)- child model ที่ใส่
#[Connection]ใช้ connection ของตัวเอง ไม่โดน$connectionของ parent class ทับอีก (PR #62065) - unique broadcast event ที่โดนข้ามจะยิง event
UniqueJobSkippedเหมือน unique job ทั่วไป (PR #62077)
รายการ PR ทั้งหมดกว่า 30 ตัวอยู่ในโพสต์ต้นฉบับของ Laravel News ครับ