database queue เก็บงานไว้ในตาราง jobs
Laravel มี queue หลายแบบ แบบที่ตั้งง่ายที่สุดคือ QUEUE_CONNECTION=database เพราะไม่ต้องลงอะไรเพิ่ม ใช้ฐานข้อมูลเดิมของเว็บได้เลย งานแต่ละชิ้นเป็นแถวหนึ่งในตาราง jobs แล้ว worker (php artisan queue:work) ทำงานวนเป็นรอบแบบนี้
- หาแถวที่เก่าที่สุดที่ยังไม่มีใครจอง แล้วล็อกแถวนั้นไว้
- เขียนลงแถวว่าจองแล้ว (
reserved_at) และนับรอบ (attempts) เพิ่มหนึ่ง - รันงาน เช่น ส่งอีเมลยืนยันคำสั่งซื้อ
- ลบแถวทิ้งเมื่องานเสร็จ
ถ้ามี worker ตัวเดียวก็ไม่มีอะไรต้องห่วง แต่พอเปิดหลายตัวให้งานเดินเร็วขึ้น worker ทุกตัวจะแย่งกันอ่านแถวชุดเดียวกัน ขั้นที่ 1 จึงต้องล็อก ไม่อย่างนั้น worker สองตัวอาจหยิบงานชิ้นเดียวกันไปทำพร้อมกัน
SKIP LOCKED ทำให้ worker ข้ามแถวที่คนอื่นล็อกอยู่
การล็อกแถวตอนอ่านใช้คำสั่ง SELECT … FOR UPDATE ซึ่งมีสองแบบ
FOR UPDATEธรรมดา ถ้าแถวที่อยากได้ถูก worker ตัวอื่นล็อกอยู่ ก็ต้องยืนรอจนกว่าอีกฝ่ายจะปล่อยFOR UPDATE SKIP LOCKEDแถวไหนมีคนล็อกอยู่ก็ข้ามไปหยิบแถวถัดไปเลย ไม่ต้องรอใคร
แบบหลังเหมาะกับ queue มาก เพราะเราไม่ได้สนว่าต้องได้งานชิ้นไหน ขอแค่ได้สักชิ้นที่ยังว่าง แต่ฐานข้อมูลรุ่นเก่ายังไม่รองรับ Laravel จึงดูรุ่นของฐานข้อมูลก่อนเลือก (DatabaseQueue::getLockForPopping())
| ฐานข้อมูล | ได้ SKIP LOCKED ตั้งแต่ | ต่ำกว่านั้นได้ |
|---|---|---|
| MySQL | 8.0.1 | FOR UPDATE ธรรมดา |
| MariaDB | 10.6 | FOR UPDATE ธรรมดา |
| PostgreSQL | 9.5 | FOR UPDATE ธรรมดา |
| SQL Server | ทุกรุ่น (ใช้ readpast แทน) |
ที่น่าสนใจคือเอกสารของ Laravel 13 ยังบอกว่ารองรับ MySQL 5.7 และ MariaDB 10.3 ขึ้นไป ระบบจึงรันได้ปกติบนรุ่นเหล่านั้น แค่ queue หยิบงานด้วยวิธีที่ช้ากว่าและชนกันง่ายกว่า ถ้าเว็บอยู่บน shared hosting หรือ VPS ที่ตั้งไว้นานแล้ว ฐานข้อมูลอาจยังเป็นรุ่นในคอลัมน์ขวาอยู่ก็ได้
worker สองตัวล็อกกันคนละลำดับจนเกิด deadlock
ทีนี้ลองนึกถึงจังหวะที่ worker สองตัวทำงานพร้อมกัน
- worker A เพิ่งรันงานเสร็จ กำลังลบแถวของตัวเอง จึงถือล็อกของแถวนั้นไว้ แล้วต้องไปแก้ index ของคอลัมน์
queueต่อ - worker B กำลังหางานชิ้นถัดไปด้วย
FOR UPDATEธรรมดา ล็อก index ของคอลัมน์queueไว้ระหว่างไล่หา แล้วไปเจอแถวที่ A ถืออยู่ จึงยืนรอ
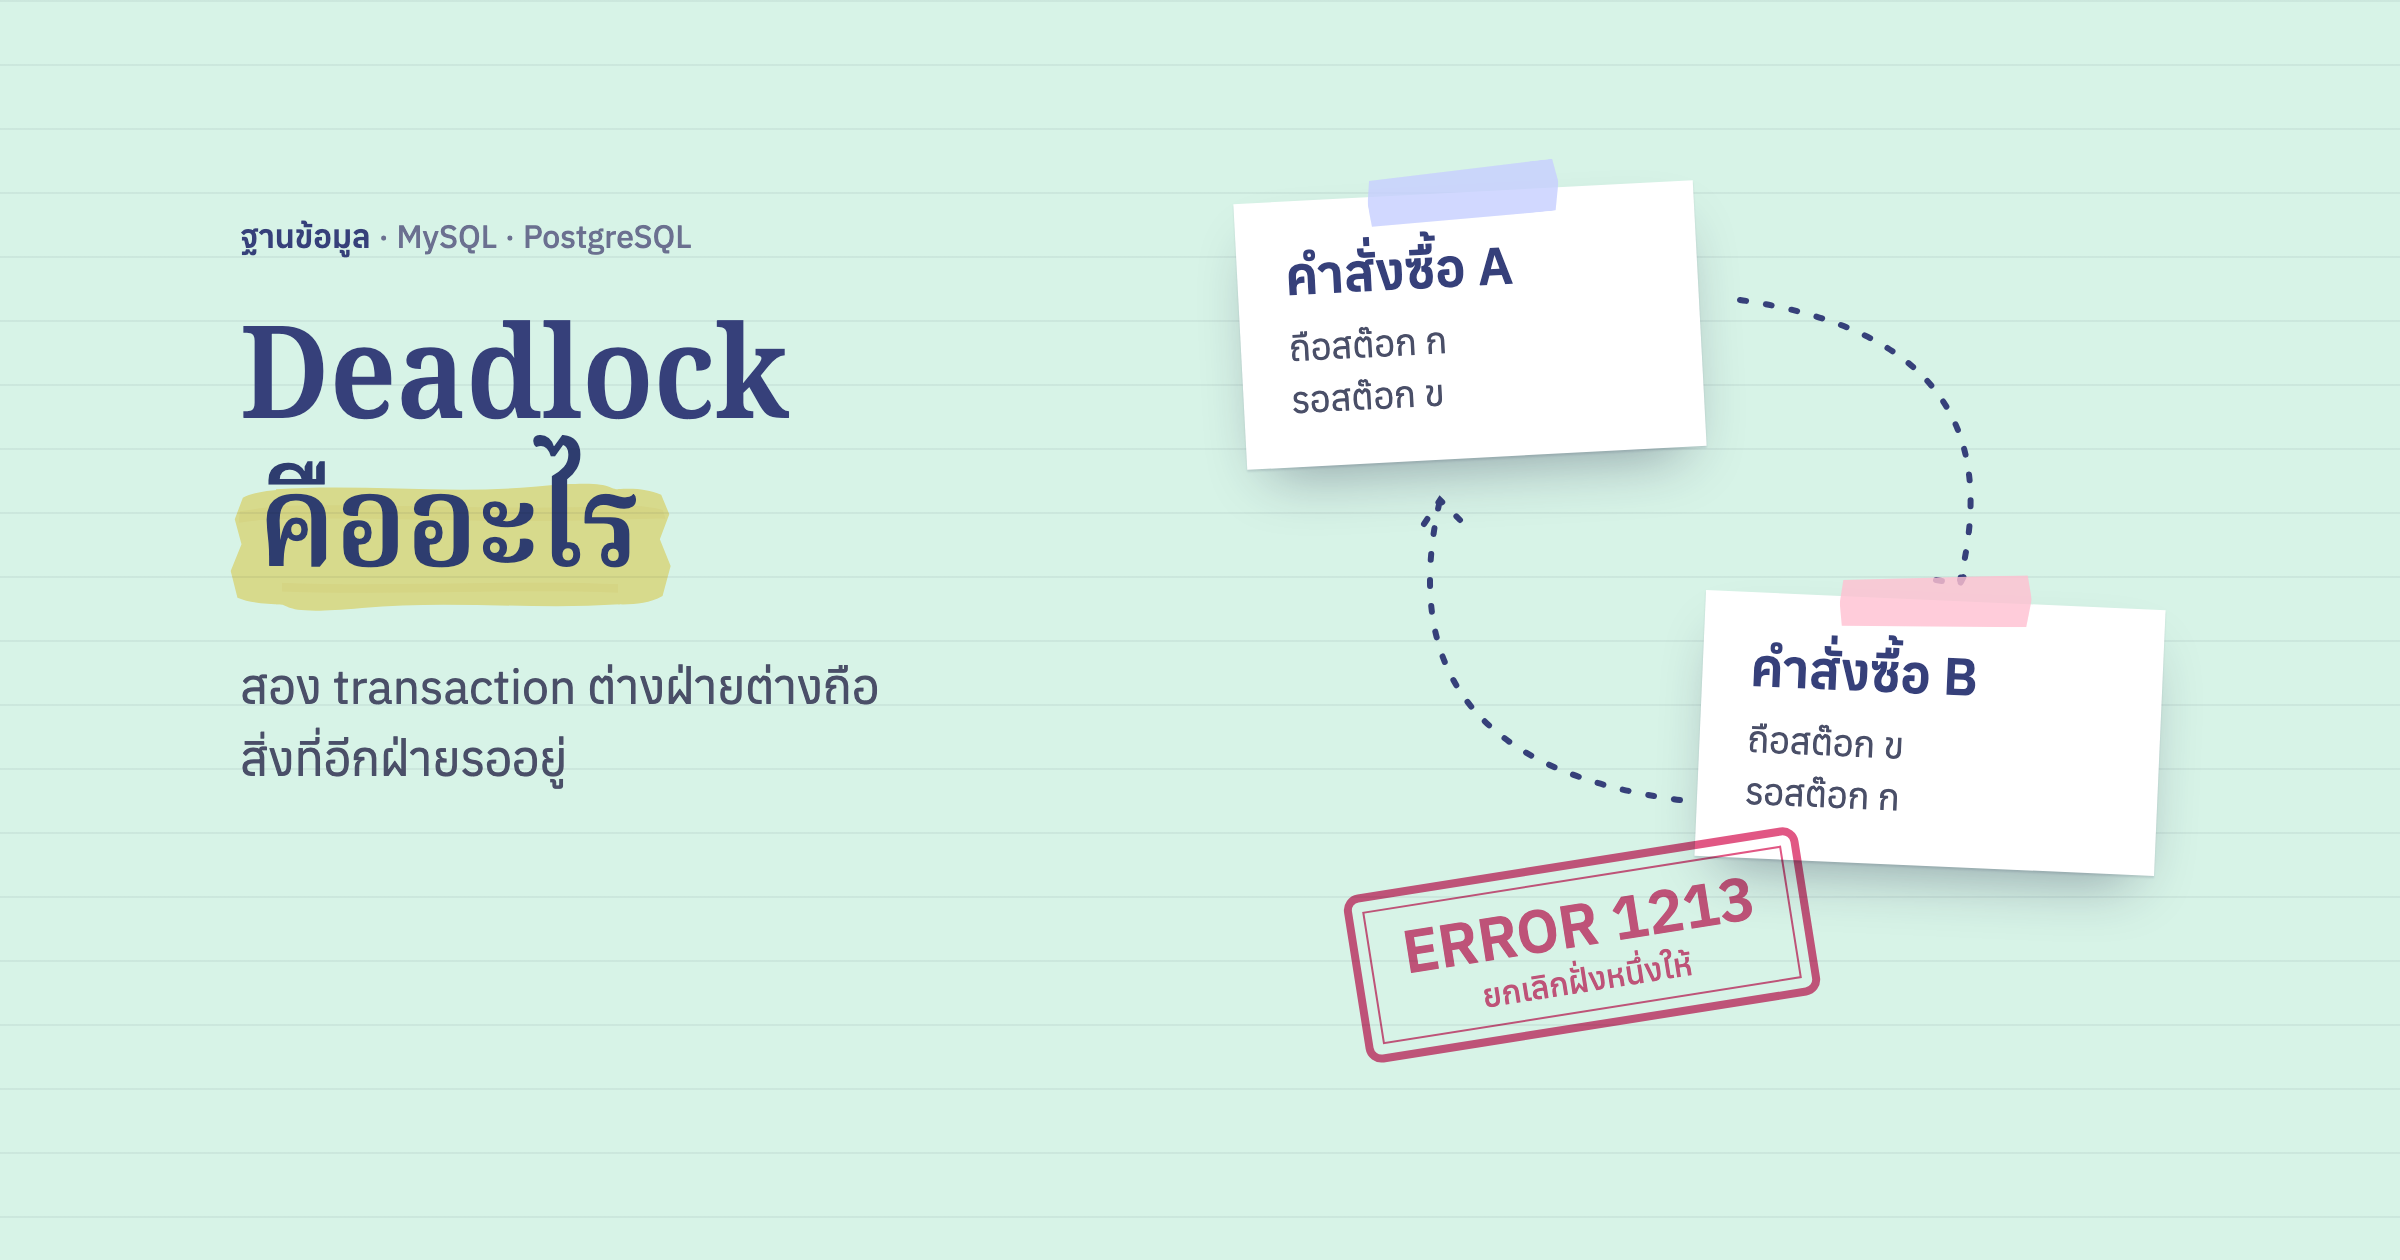
A รอสิ่งที่ B ถือ B รอสิ่งที่ A ถือ ต่างฝ่ายต่างรอกันไม่จบ อาการนี้เรียกว่า deadlock (อ่านว่า deadlock คืออะไรได้ที่นี่) MySQL เห็นแล้วจะยกเลิกฝั่งหนึ่งทิ้งทันทีพร้อม error 1213 Deadlock found when trying to get lock ถ้าฝั่งที่โดนยกเลิกเป็นคำสั่ง DELETE ของ A ปัญหาก็เริ่มตรงนั้น
ถ้าได้ SKIP LOCKED B จะไม่ยืนรอแถวของ A แต่ข้ามไปเลย วงจรรอกันจึงไม่เกิดตั้งแต่แรก
job ที่ทำเสร็จแล้วจึงกลับมาอีกรอบ
ตอน DELETE ล้มเหลว งานของ A ทำไปแล้วจริง ๆ อีเมลส่งออกไปแล้ว แต่แถวของงานยังอยู่ในตาราง ยังมีสถานะจองแล้ว และ attempts เป็น 1 Laravel ไม่ลองลบซ้ำให้ แถวนั้นจึงค้างไว้อย่างนั้น
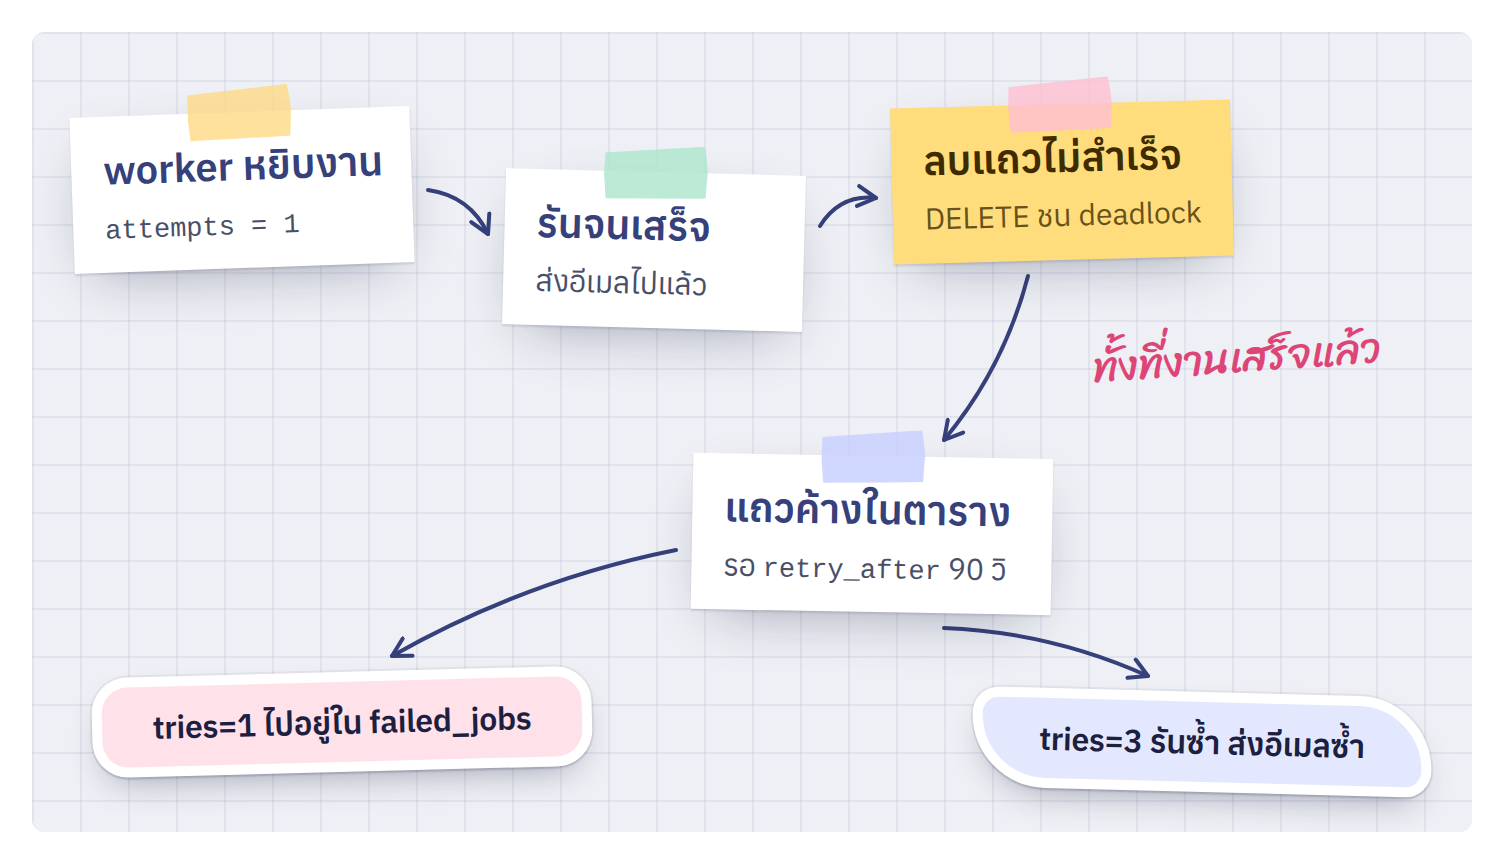
แถวที่ลบไม่สำเร็จจะรอจนครบ retry_after แล้ว worker ตัวถัดไปจะหยิบขึ้นมาเป็นรอบที่สอง
database queue ถือว่างานที่จองไว้นานเกิน retry_after (ค่าเริ่มต้น 90 วินาทีใน config/queue.php) เป็นงานของ worker ที่ตายไปแล้ว worker ตัวถัดไปจึงหยิบแถวนั้นขึ้นมาเป็นรอบที่สอง ผลที่ตามมาขึ้นกับ --tries ที่ตั้งไว้
--tries=1(ค่าเริ่มต้น) รอบที่สองเกินโควตาแล้ว Laravel จึงย้ายงานไปfailed_jobsด้วยMaxAttemptsExceededExceptionโดยไม่รันอีก เมธอดfailed()ของ job ก็ทำงานด้วย ถ้าเราเขียนให้แจ้งลูกค้าว่าทำรายการไม่สำเร็จ ลูกค้าก็จะได้ข้อความนั้นทั้งที่รายการสำเร็จไปแล้ว--tries=3รอบที่สองยังอยู่ในโควตา งานจึงรันซ้ำอีกรอบ อีเมลออกไปสองฉบับ หรือถ้าเป็นงานตัดสต๊อก สต๊อกก็หายไปสองเท่า
Mozex วัดผลบนเครื่องเดียวกัน (Laravel 13.33, 2,000 job, worker 8 ตัว) ได้ตัวเลขแบบนี้
| เซิร์ฟเวอร์ | ล็อกที่ใช้ | deadlock ตอน DELETE ต่อรอบ | เวลารันทั้งหมด |
|---|---|---|---|
| MySQL 8.4 | SKIP LOCKED | 0 | 9–11 วินาที |
| MySQL 8.4 (บังคับให้ใช้แบบเก่า) | FOR UPDATE ธรรมดา | 548–810 | 21–23 วินาที |
| MySQL 5.7 | FOR UPDATE ธรรมดา | 0–622 | 8–20 วินาที |
แค่เปลี่ยนวิธีล็อกบนเซิร์ฟเวอร์เดิม deadlock ก็หายหมดและงานเสร็จเร็วขึ้นราวเท่าตัว ส่วนบน MySQL 5.7 ผลแกว่งมาก 4 ใน 9 รอบไม่มี deadlock เลย อาการแบบนี้จึงหาตัวยาก เพราะบางวันก็ไม่เกิด
เช็กว่า queue ของเราใช้ล็อกแบบไหน
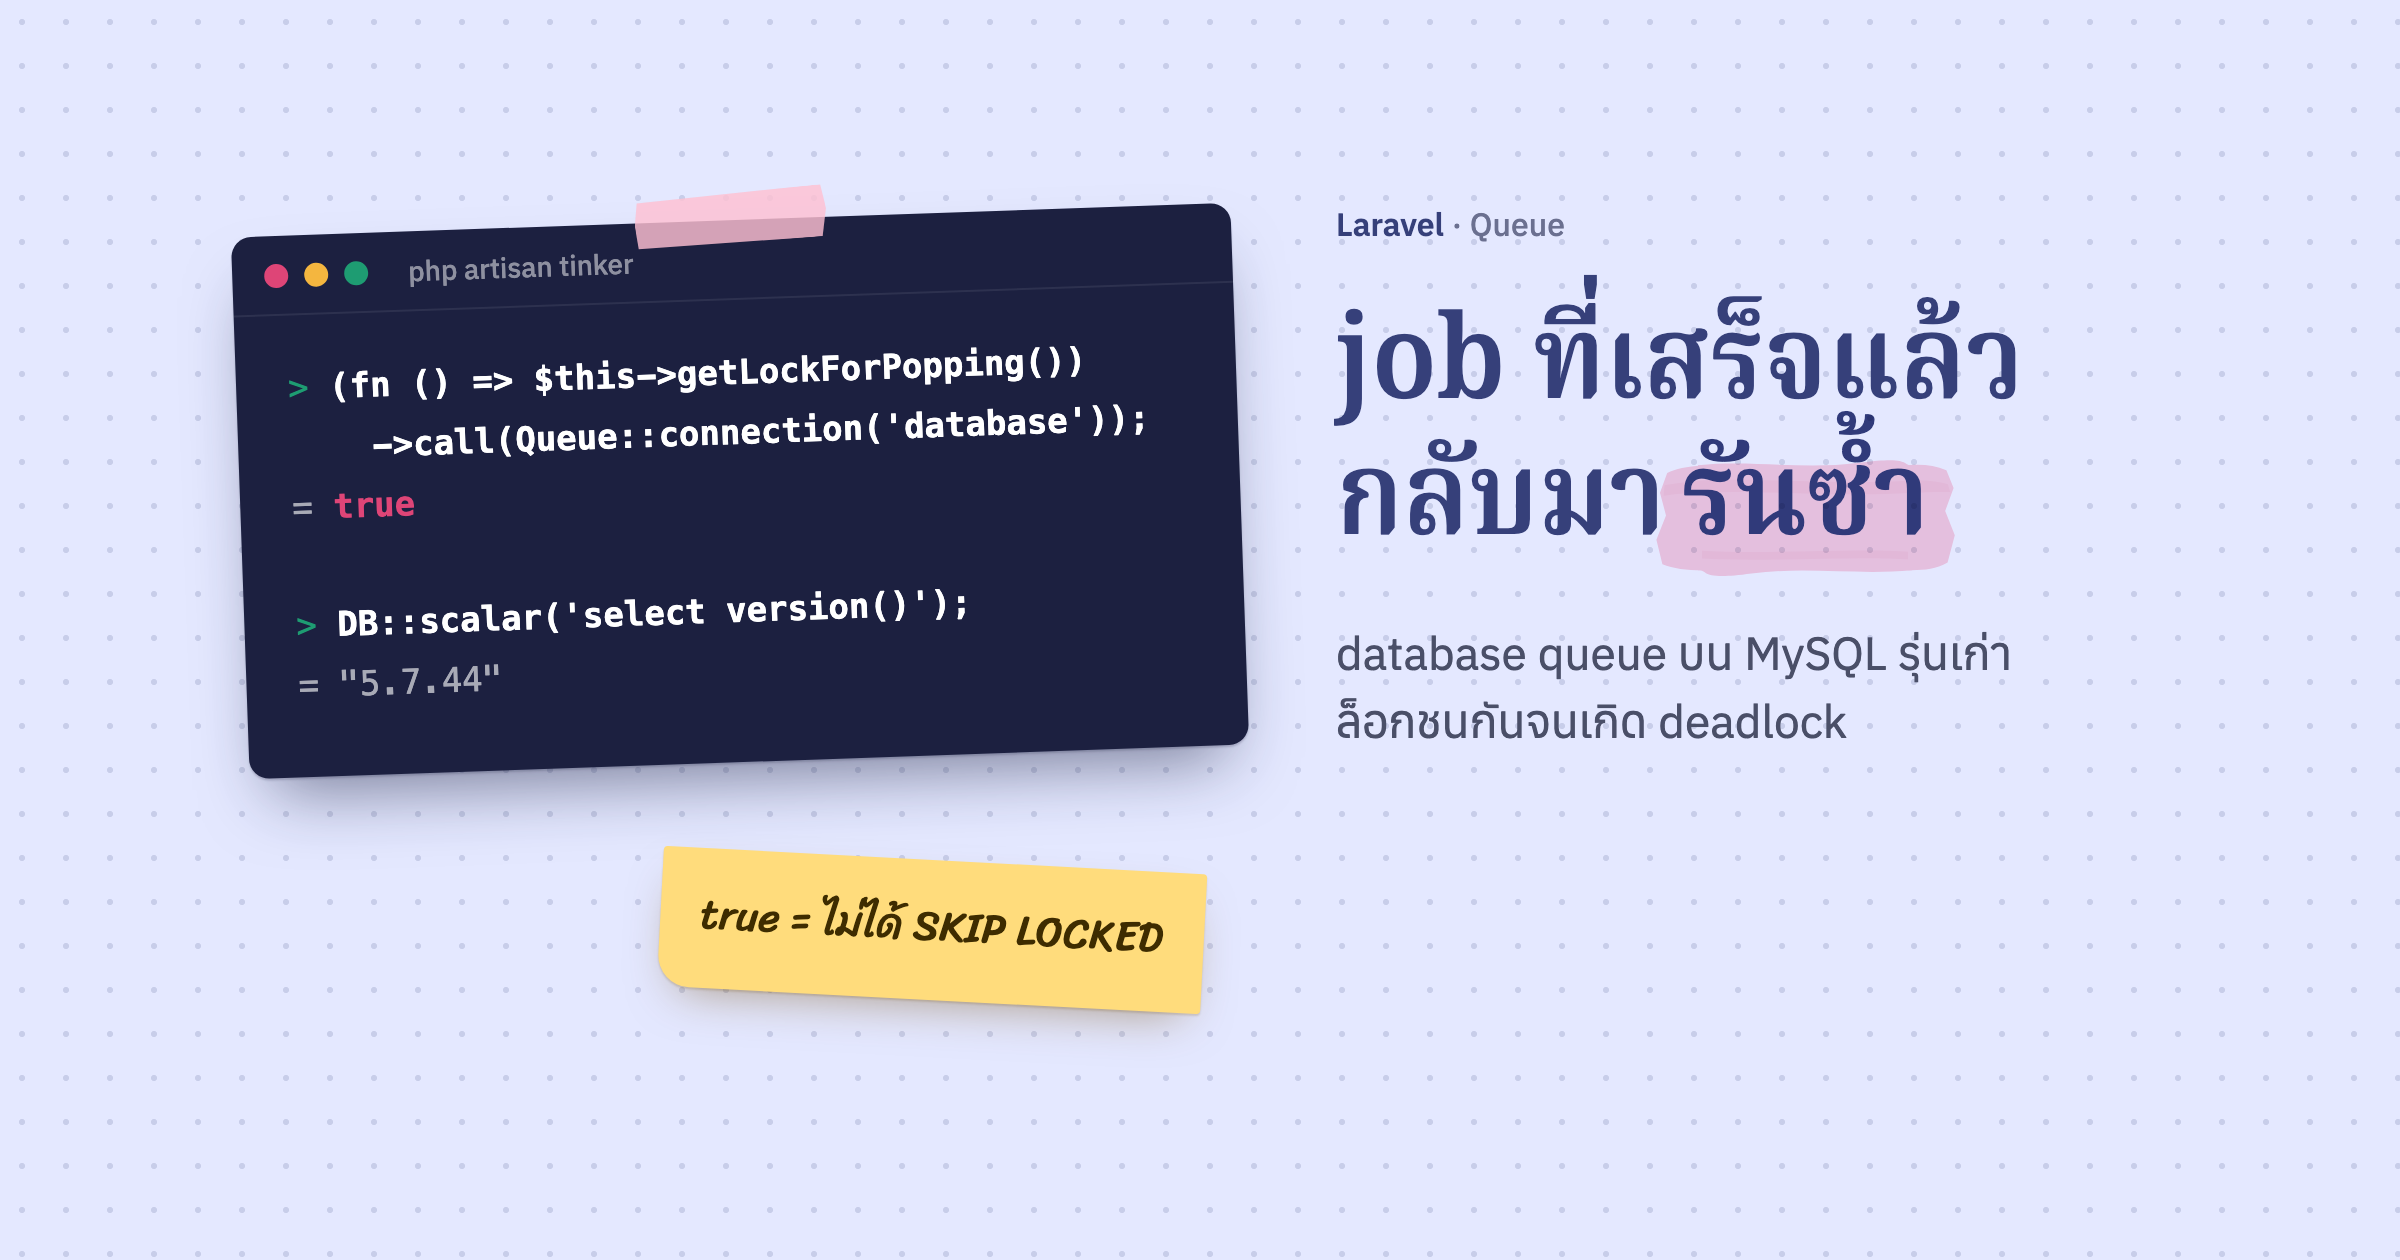
Laravel ไม่ได้บอกเราตรง ๆ แต่เรียกเมธอดที่ Laravel ใช้เลือกล็อกผ่าน tinker ได้
php artisan tinker --execute 'dump((fn () => $this->getLockForPopping())->call(app("queue")->connection("database")));'
"FOR UPDATE SKIP LOCKED"ถ้าได้ "FOR UPDATE SKIP LOCKED" ก็สบายใจได้ ถ้าได้ true แปลว่า Laravel ใช้ FOR UPDATE ธรรมดา ให้ดูต่อว่าฐานข้อมูลเป็นรุ่นอะไรด้วย SELECT VERSION(); หรือ php artisan db:show
ถ้าฐานข้อมูลเป็นรุ่นใหม่แต่ยังได้ true แปลว่า Laravel อ่านรุ่นผิด ต้นฉบับยกตัวอย่าง MySQL แบบ managed ของ Azure ที่เมื่อปี 2020 เคยรายงานตัวเองเป็น 5.6.42 ทั้งที่เป็น 8.0
แก้ได้หลายทาง เริ่มจากอัปเกรดฐานข้อมูล
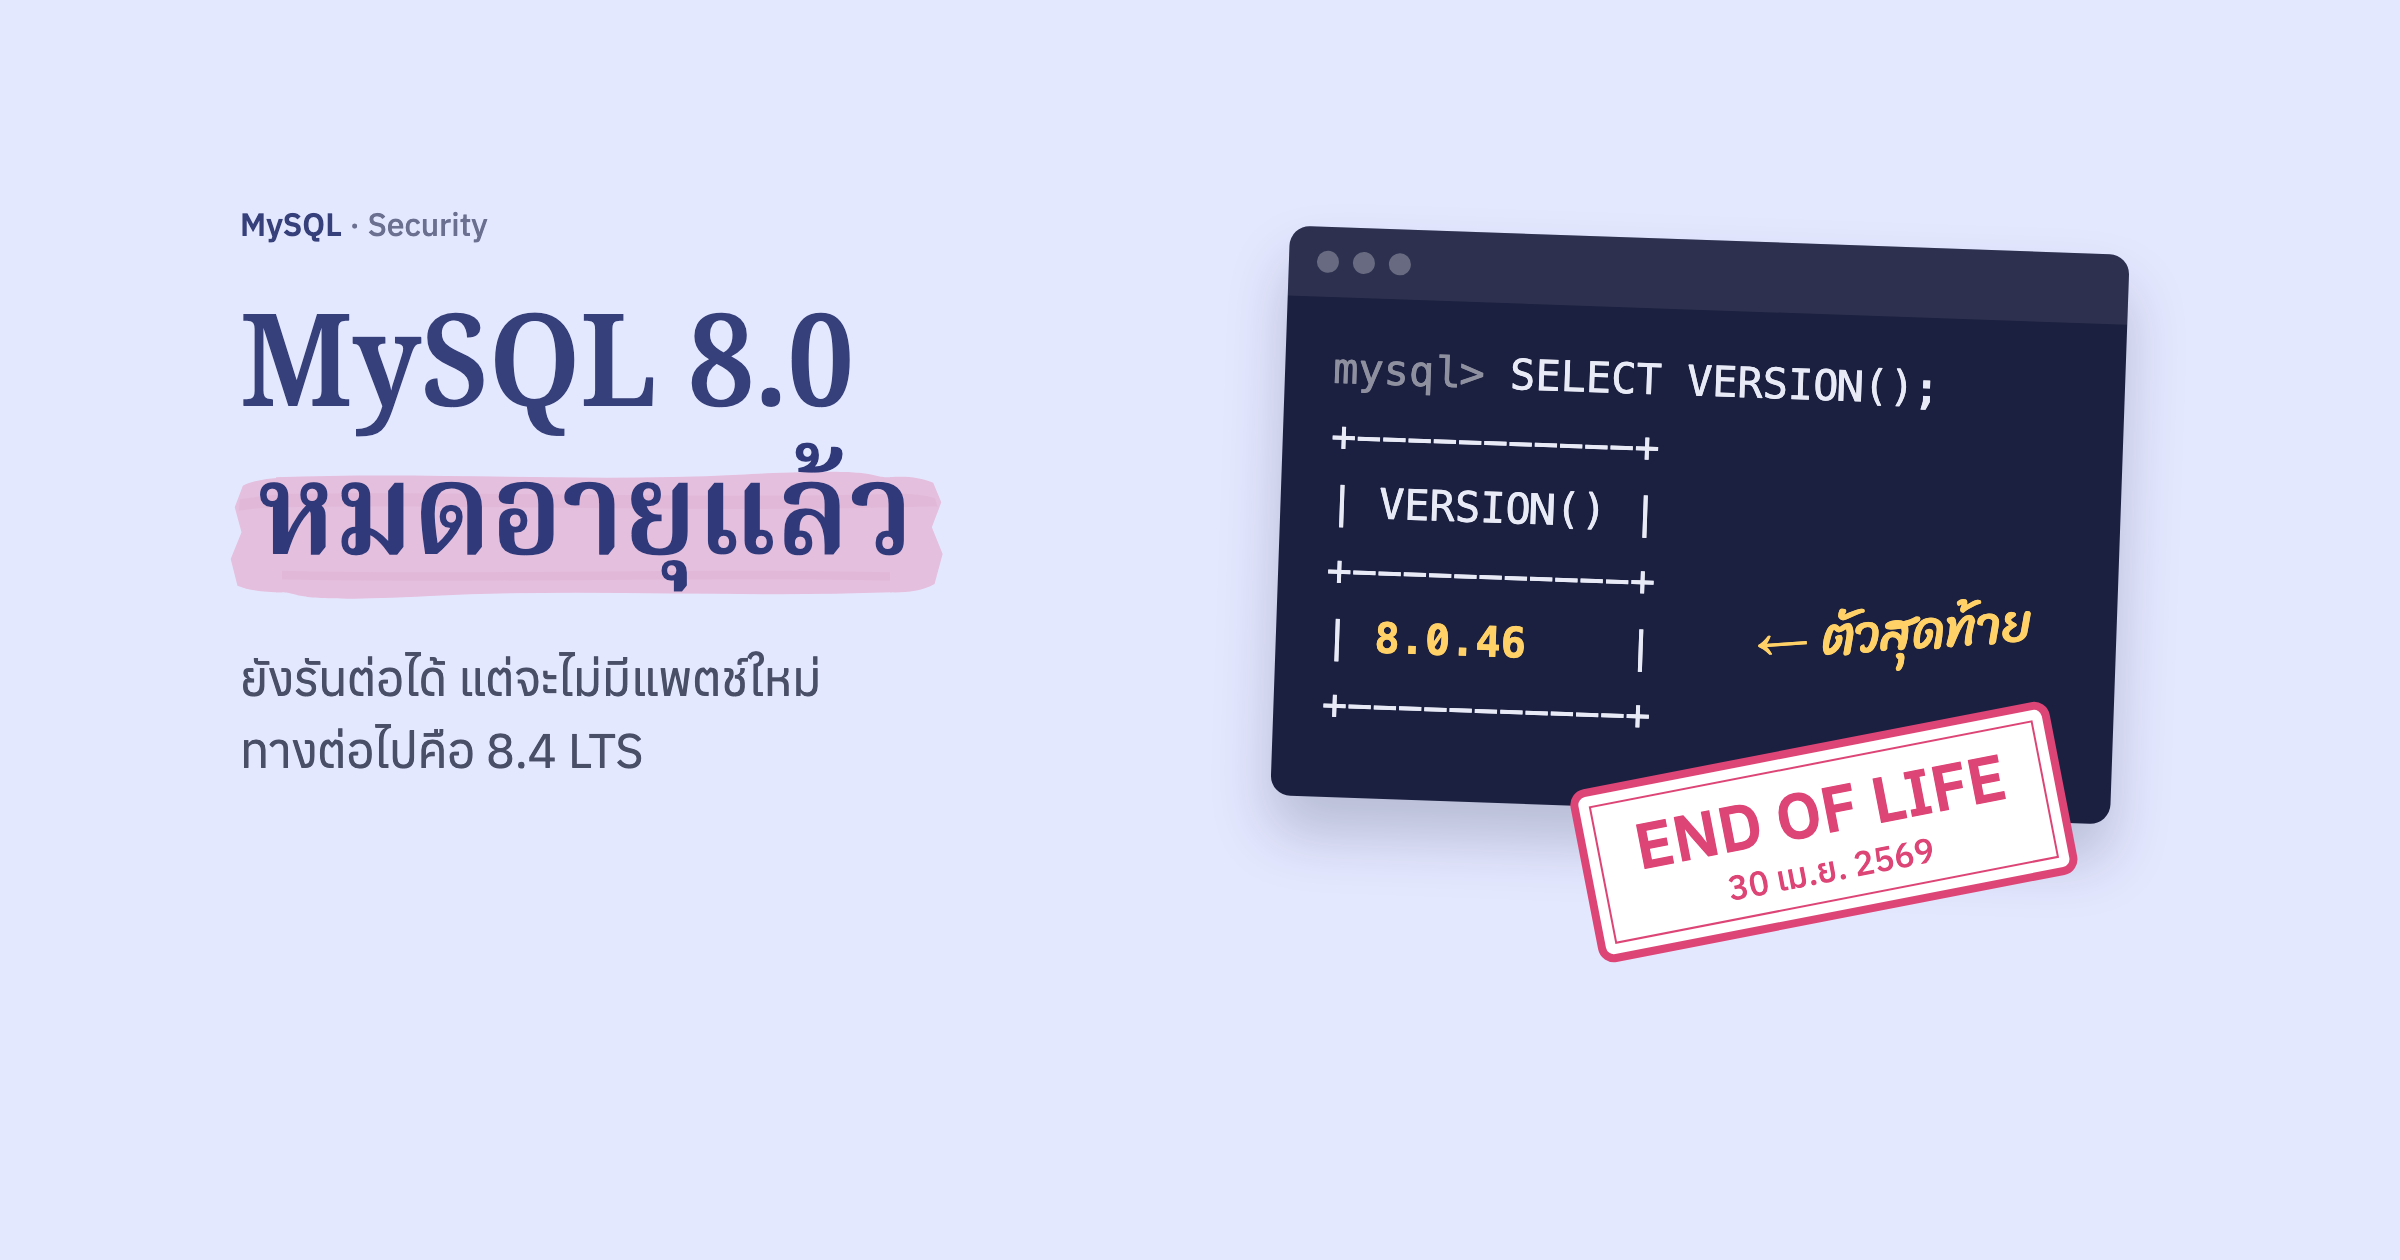
อัปเกรดฐานข้อมูล เป็น MySQL 8.0 ขึ้นไป หรือ MariaDB 10.6 ขึ้นไป เป็นทางที่ตรงที่สุด MySQL 5.7 หมดอายุการดูแลไปตั้งแต่ตุลาคม 2023 แล้ว อัปเกรดไว้ก็ได้ประโยชน์เรื่องอื่นด้วย
บอกรุ่นให้ Laravel เอง ถ้าฐานข้อมูลรองรับแล้วแต่ Laravel อ่านรุ่นผิด ให้ใส่ version ใน connection ของ config/database.php เป็นรุ่นจริงของเซิร์ฟเวอร์
'mysql' => [
    'driver' => 'mysql',
    // ...
    'version' => '8.0.36',
],
ค่านี้ไม่ได้มีผลแค่กับ queue Laravel ใช้ค่าเดียวกันเลือก sql_mode ตอนเชื่อมต่อด้วย ถ้าใส่รุ่นผิดจากของจริง query บางตัวอาจทำงานต่างไปจากเดิม จึงควรใส่ตามที่ SELECT VERSION(); บอกเท่านั้น
ย้าย queue ไป Redis Redis queue ไม่ได้ใช้การล็อกแถวในฐานข้อมูล ปัญหานี้จึงไม่มีตั้งแต่ต้น และงานไม่ต้องไปแย่งฐานข้อมูลกับหน้าเว็บด้วย ถ้าเซิร์ฟเวอร์ลง Redis ได้ ก็คุ้มที่จะย้ายเมื่อ queue เริ่มมีงานเยอะ
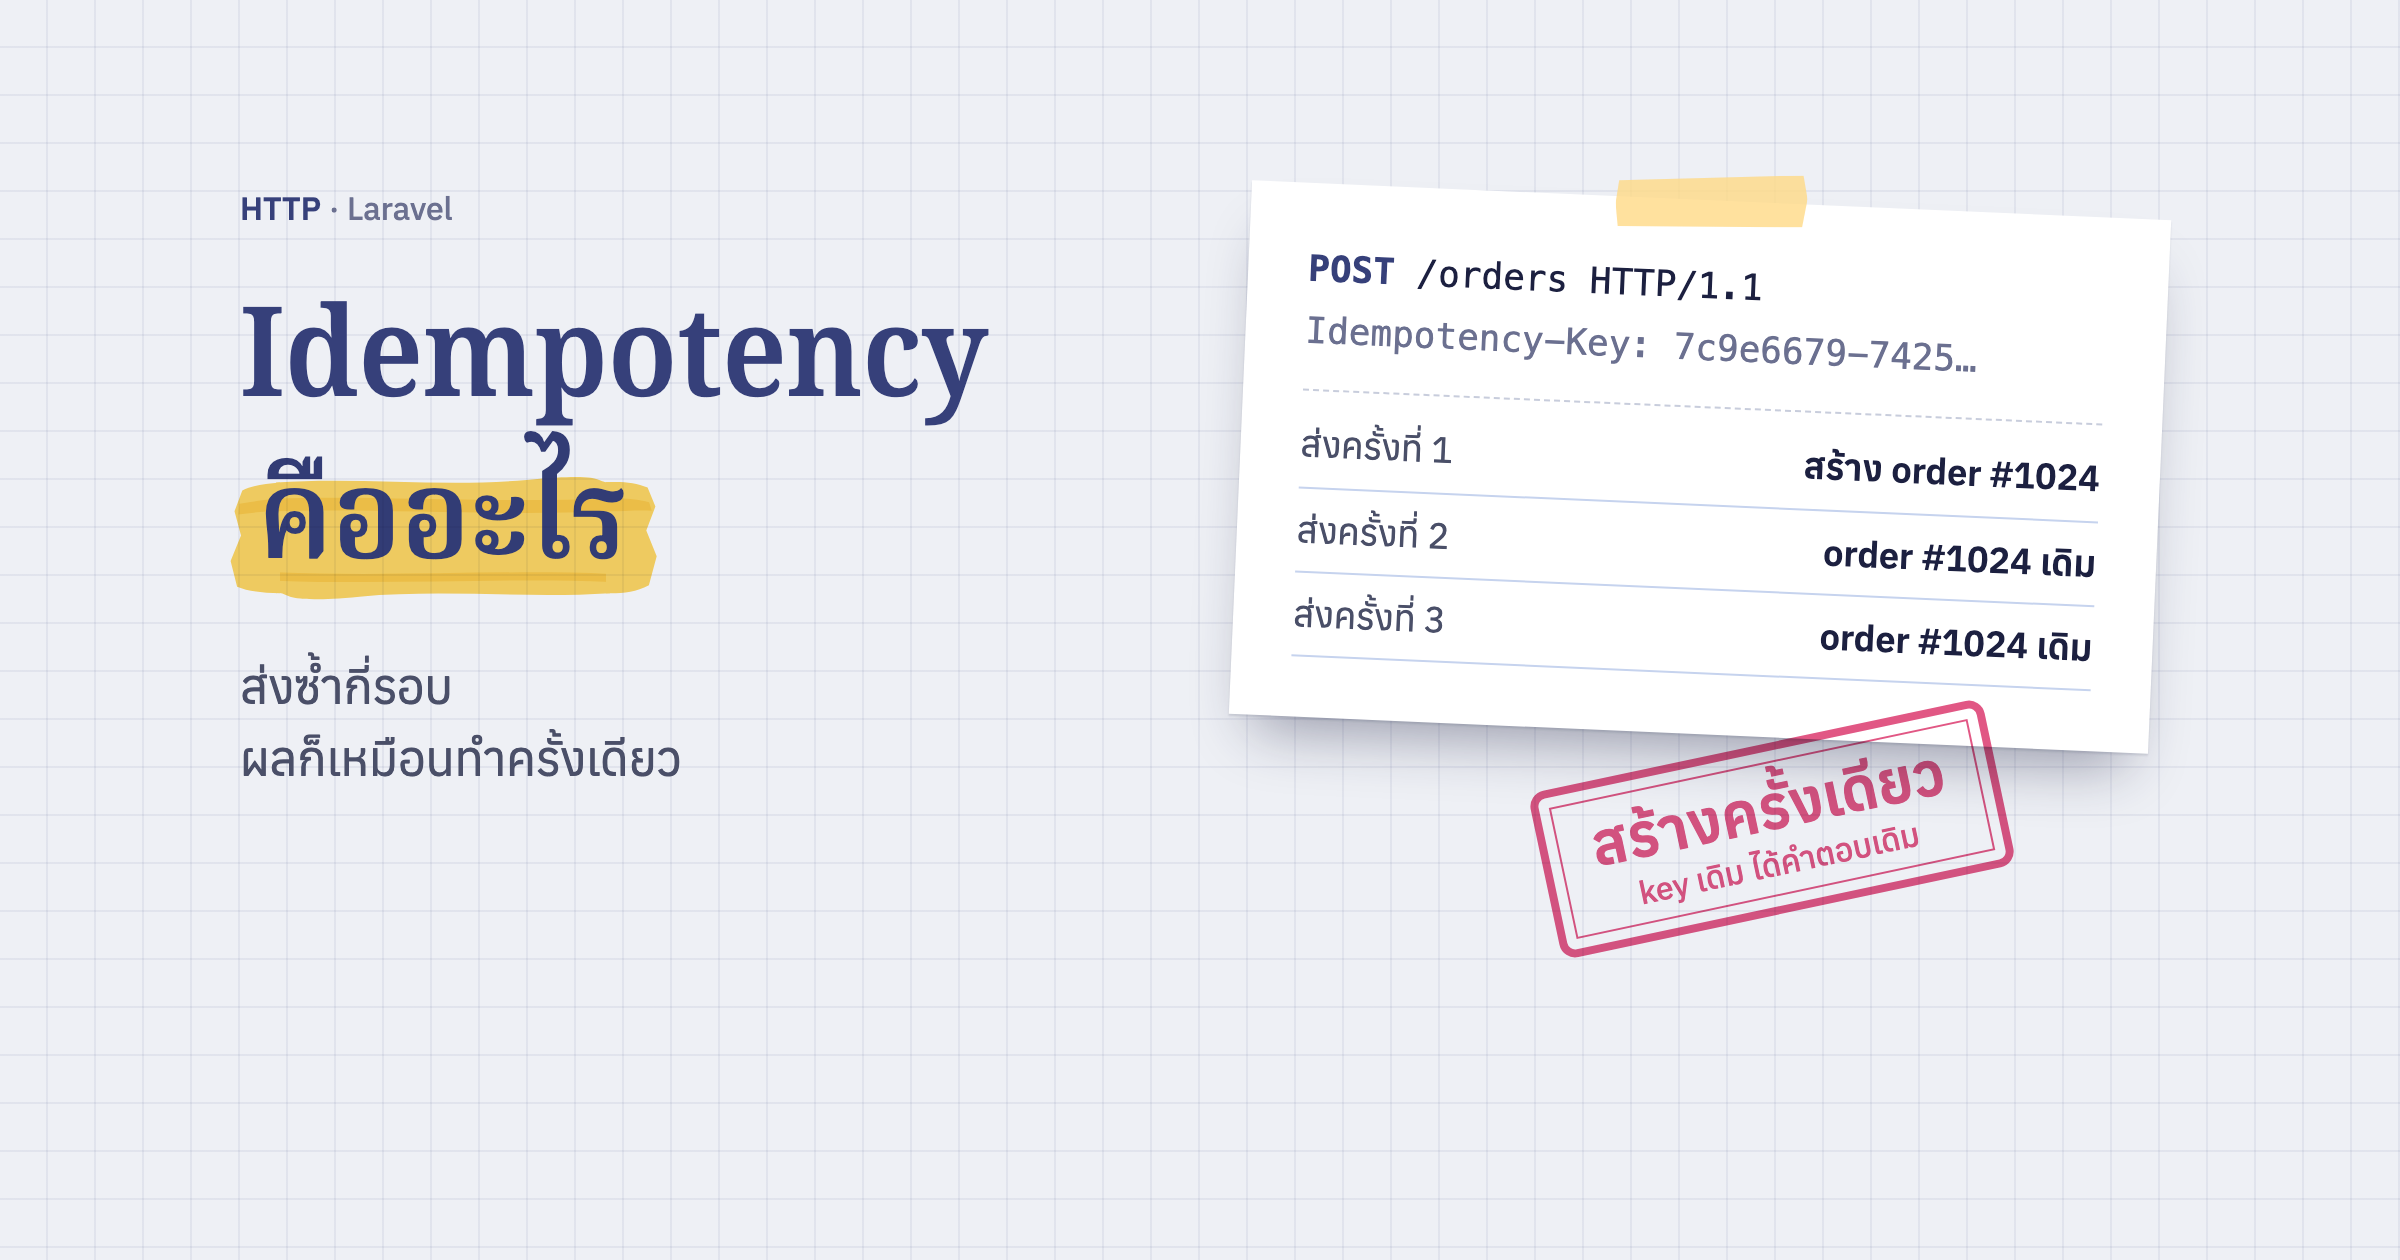
ทำให้ job รันซ้ำได้โดยไม่เกิดผลซ้ำ ข้อนี้ทำไว้เสมอ ไม่ว่าจะใช้ queue แบบไหน เพราะ worker ที่โดน kill กลางงาน หรือ deploy ระหว่างงานรันอยู่ ก็ทำให้งานรันซ้ำได้เหมือนกัน วิธีคิดอยู่ในโพสต์ Idempotency คืออะไร และถ้า job ถูกสั่งจากใน transaction ให้รอ transaction commit ก่อน
ต้นฉบับยังเล่าวิธีลบ index ของคอลัมน์ queue ออก ที่มีคนเสนอไว้ใน issue #31660 ด้วย วิธีนี้ช่วยได้ในการทดลองบน MySQL 8.4 แต่ผู้ดูแล Laravel ไม่เห็นด้วย เพราะ query หยิบงานกรองด้วยคอลัมน์นี้ และผลบน MySQL 5.7 ก็ยังไม่ชัด จึงไม่ใช่ทางแรกที่ควรลอง
งานที่ค้างใน failed_jobs อาจไม่ได้ล้มเหลวจริง
ก่อนกด php artisan queue:retry all ให้ดูก่อนว่างานไหนเป็น MaxAttemptsExceededException เพราะงานกลุ่มนี้อาจทำเสร็จไปแล้วรอบหนึ่ง ถ้า retry ก็คือรันซ้ำอีกรอบ แต่ใช่ว่าทุกแถวจะมาจาก deadlock งานที่ worker โดน kill กลางทาง หรือรันนานเกิน retry_after ก็ขึ้น exception เดียวกัน
ระบบที่ต่อ SAP ของเราตัวหนึ่งเคยใช้ database queue บน MySQL 8.0 ดึงเอกสารจาก SAP ทุกนาที แล้วส่งต่อให้ผู้ให้บริการ e-Tax Invoice และธนาคาร ตาราง failed_jobs ของระบบนี้โตไปถึง 366 MB ราว 12,700 แถว ใหญ่กว่าตารางข้อมูลจริงทุกตาราง ในสัปดาห์เดียวมี Deadlock found when trying to get lock 30 ครั้ง และ MaxAttemptsExceededException อีก 53 ครั้ง รุ่นนี้ได้ SKIP LOCKED แล้วก็จริง แต่งานยังต้องแย่งล็อกในตาราง jobs กับงานอื่นที่วิ่งทุกนาที และ retry_after ก็สั้นกว่างานบางตัว หลังย้าย queue ไป Redis กับ Horizon และตั้ง timeout ของ job (90 วินาที) ให้น้อยกว่า retry_after (180 วินาที) ก็ไม่เจอทั้งสองแบบอีกเลย
ถ้ายังใช้ database queue อยู่ ลองตั้ง schedule ของ queue:prune-failed ไว้ด้วย ตาราง failed_jobs จะได้ไม่โตเงียบ ๆ แบบนั้น