เพิ่ม worker ไม่ได้ทำให้คิวเร็วขึ้นเสมอไป
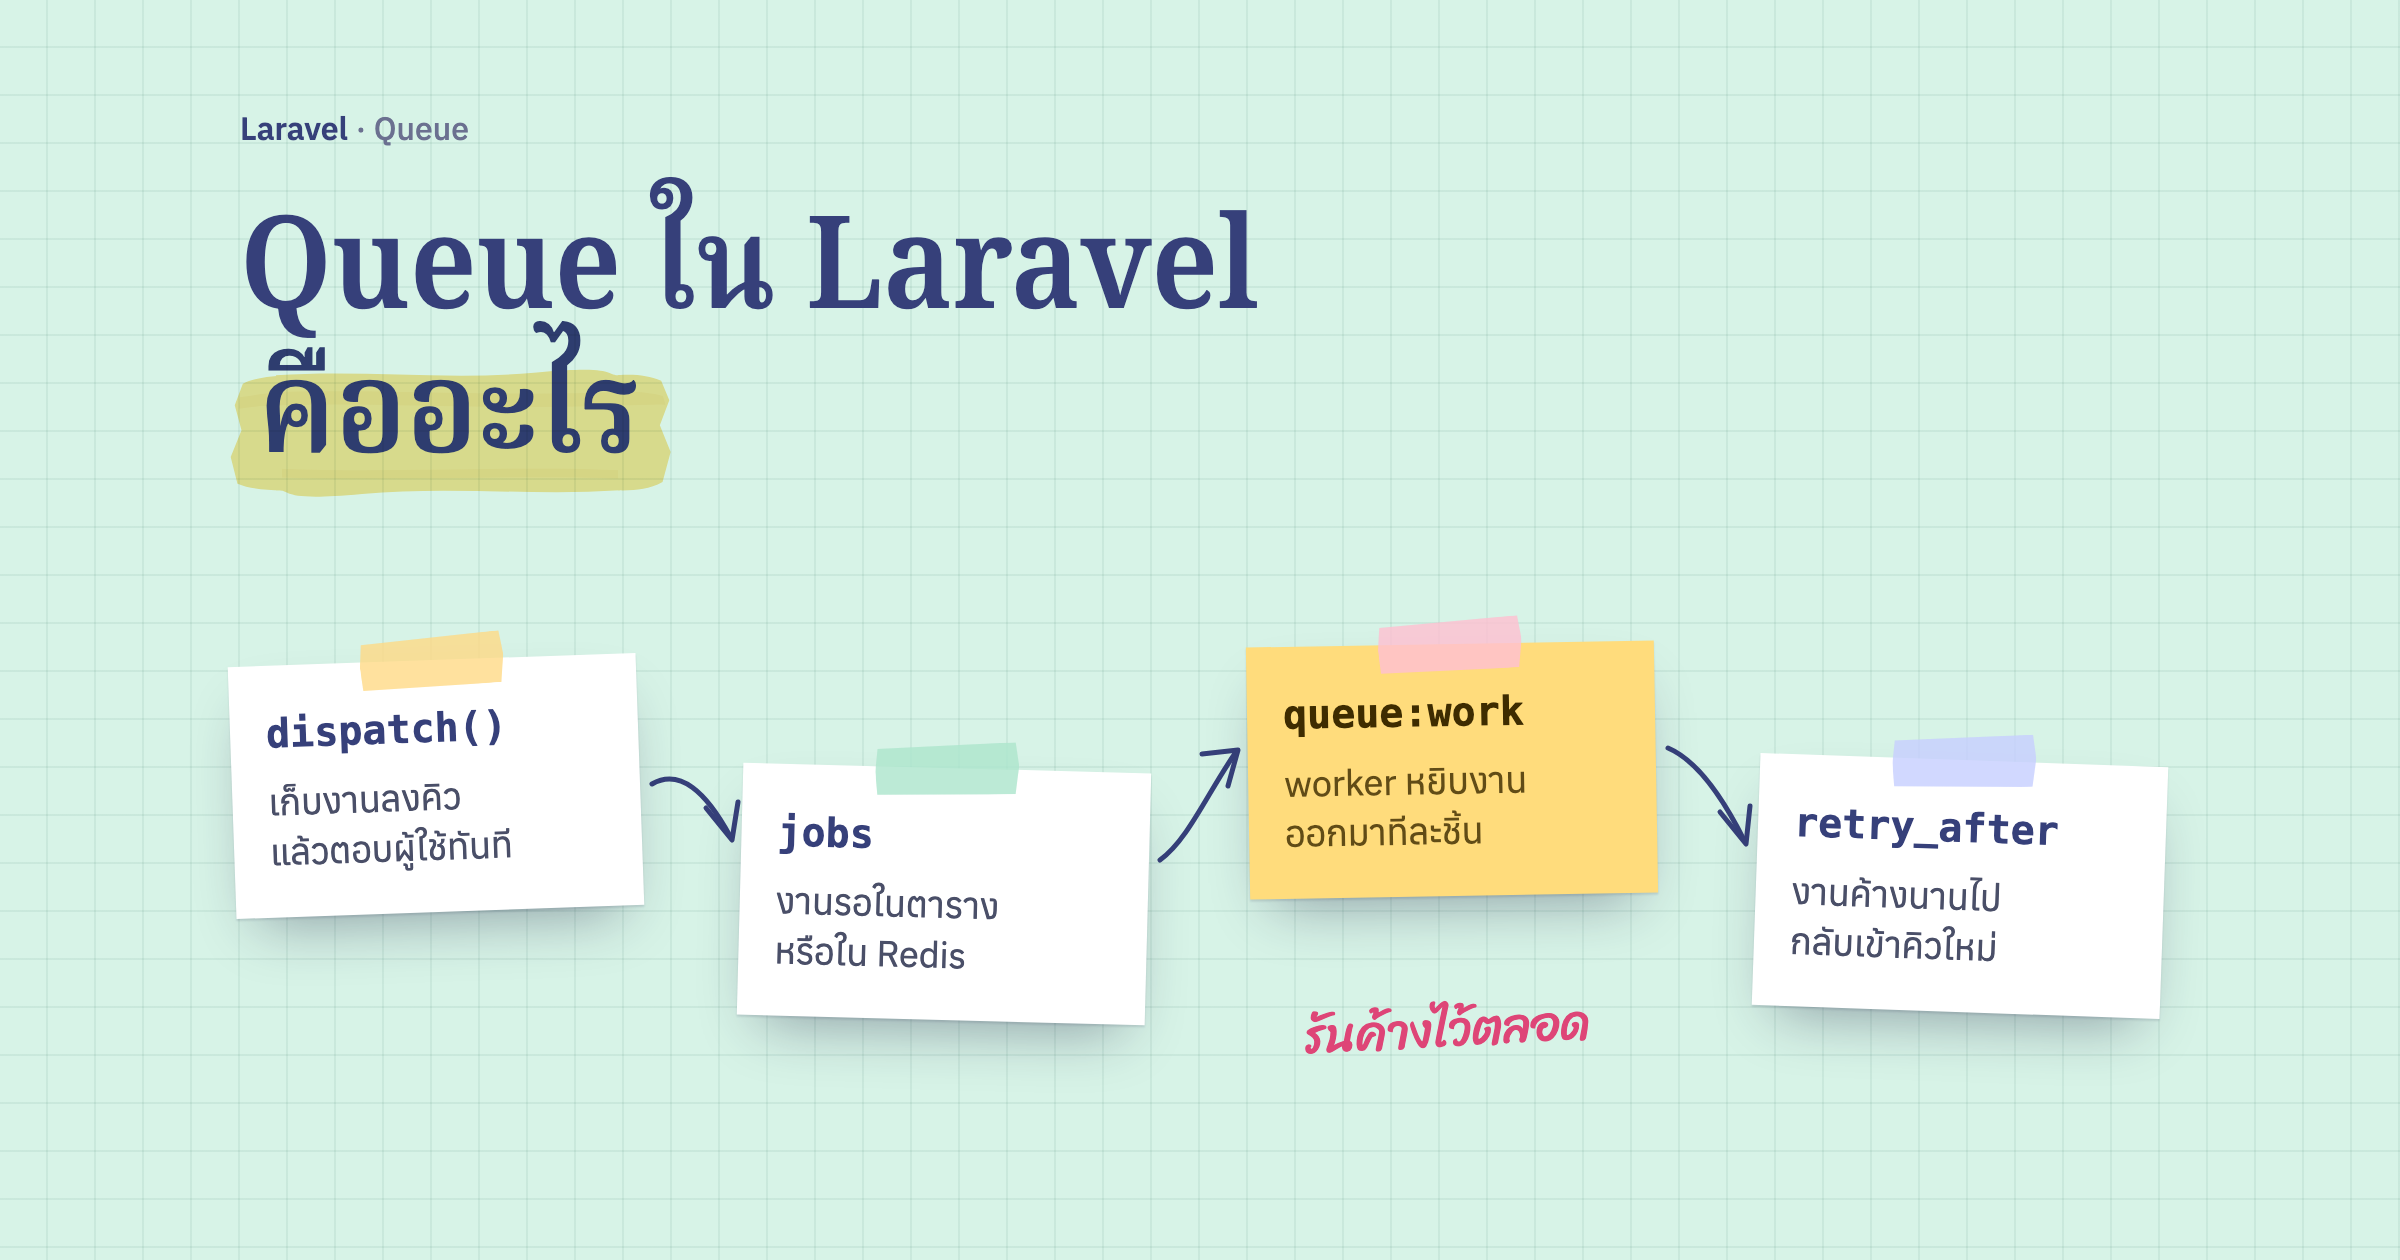
Horizon เป็นตัวคุม queue worker บน Redis ของ Laravel มีหน้า dashboard ให้ดูว่างานค้างกี่ชิ้น ช้าแค่ไหน และตั้งจำนวน worker ของแต่ละคิวไว้ใน config/horizon.php ที่เดียว ถ้ายังไม่คุ้นกับคำว่า job, worker และ retry_after ลองอ่านQueue ใน Laravel คืออะไรก่อนได้ครับ
Horizon ต้องมี Redis และ process ที่รันค้างไว้ตลอด จึงใช้บน VPS หรือ server ที่เราดูแลเอง บน shared hosting ที่มีแต่ cron ปกติเราจะใช้ database queue แทน
ต้นฉบับเล่าว่าทุกครั้งที่ส่งแคมเปญอีเมล server load ขึ้นสูง เว็บช้าลง และ PHP-FPM ก็ทำงานหนัก พอเห็นแบบนี้ ทางที่คิดออกเป็นอย่างแรกคือเพิ่ม maxProcesses แต่ถ้าตั้งค่าเดิมยังมีจุดผิดอยู่ worker ที่เพิ่มเข้าไปก็แค่ทำงานผิดเร็วขึ้น เขาจึงเอา config มาเทียบกับงานที่รันจริงทีละข้อก่อน
ไล่ดูก่อนว่าใครดึงงานจากคิวเดียวกันบ้าง
เริ่มจากจดให้ครบว่ามี supervisor ของ Horizon กี่ตัว และมี queue:work ที่รันแยกไว้ที่ไหนบ้าง แล้วดูของแต่ละตัวว่าใช้ Redis database ไหน prefix อะไร และชื่อคิวอะไร
จุดที่หลุดง่ายคือ connection สองชื่อใน config/queue.php อาจชี้ไปที่ key ของคิวใน Redis ตัวเดียวกัน ถ้าสอง connection นั้นตั้ง retry_after ไม่เท่ากัน worker ฝั่งที่ตั้งสั้นกว่าจะหยิบงานที่อีกฝั่งยังทำไม่เสร็จไปทำซ้ำได้ ต้นฉบับยกตัวอย่าง job ที่ใช้เวลาสิบนาที อาจรันสองรอบถ้า worker อีกตัวตั้ง retry_after ไว้ 90 วินาที
ระบบที่มี package ของตัวเองตั้ง connection แยก (ในต้นฉบับคือ queue_connection ของระบบส่งอีเมล) ก็ต้องเทียบด้วยว่าตรงกับ connection ที่ supervisor ใช้จริงไหม
timeout ต้องสั้นกว่ากันเป็นชั้น จาก job ออกไปถึง retry_after
retry_after คือเวลาที่ Redis ยอมให้ worker ถืองานไว้ ถ้าเกินเวลานี้แล้วงานยังไม่เสร็จ Laravel ถือว่า worker ตายไปแล้ว และปล่อยงานกลับเข้าคิวให้ worker ตัวอื่นหยิบไป ส่วน timeout ของ worker คือเวลาที่ worker ยอมให้ job หนึ่งรัน ก่อนจะฆ่า process ทิ้ง
ลำดับที่ถูกจึงเป็น timeout ของ job < timeout ของ supervisor < retry_after ถ้าสลับกัน งานที่ยังทำอยู่จะถูกหยิบไปทำซ้ำ หรือโดนฆ่ากลางทางโดยไม่ได้บันทึก error ให้เรา ต้นฉบับมี job ที่นานสุดราวสิบนาที เลยตั้งตัวเลขกลม ๆ เผื่อไว้เยอะ
// config/queue.php ทุก Redis connection ที่ใช้คิวร่วมกัน
'retry_after' => 60 * 60,

// config/horizon.php ใน supervisor ที่เกี่ยวข้อง
'timeout' => 60 * 30,
ข้อแลกคือถ้า worker ตายจริงระหว่างถืองาน งานนั้นจะรอนานขึ้นกว่าจะกลับเข้าคิว และ connection ทุกตัวที่ใช้คิวร่วมกันควรตั้ง retry_after เท่ากัน
ระบบดึงรายงานจาก ERP ตัวหนึ่งของเรามีชั้นมากกว่านั้น job ยิง query ผ่านตัวกลางที่ต่อฐานข้อมูลของ ERP แล้วสร้างไฟล์ Excel ต่อ แต่ละชั้นจึงต้องยาวกว่าชั้นในของมัน
| ชั้น | ค่าที่ตั้ง |
|---|---|
| HTTP client ที่เรียกตัวกลางของ ERP | 600 วินาที |
$timeout ของ job รายงาน |
900 วินาที |
timeout ของ supervisor ใน Horizon |
960 วินาที |
เวลาที่ systemd รอตอนสั่งหยุด Horizon (TimeoutStopSec) |
1000 วินาที |
retry_after ของ Redis connection |
1020 วินาที |
ชั้นของ HTTP client กับ systemd เป็นสองชั้นที่ต้นฉบับไม่ได้พูดถึง ถ้า HTTP timeout ยาวกว่า job ตัว job จะโดนฆ่าก่อนได้รู้ว่าปลายทางไม่ตอบ และถ้า systemd รอสั้นกว่า timeout ของ worker ทุกครั้งที่ restart งานที่รันอยู่จะโดนตัดกลางทาง ต้นฉบับแนะนำให้มี test คอยเช็กลำดับนี้ด้วย ระบบนี้ของเราก็มี test ที่อ่านค่าจาก config จริงมาเทียบกัน เพราะเคยมีคนขยับ timeout ของ job จาก 600 เป็น 900 วินาที แต่ตัวเลขอีกที่ที่อิงกับมันไม่ได้ขยับตาม
ถ้า job ทำซ้ำแล้วเกิดผลซ้ำ เช่น ส่งอีเมลสองฉบับ ตั้ง timeout ให้ถูกก็ยังกันไม่ได้ทุกกรณี ควรทำ job ให้ส่งซ้ำได้โดยไม่เกิดผลซ้ำไว้ด้วย
deploy ต้องสั่ง Horizon ให้เริ่มใหม่ได้จริง
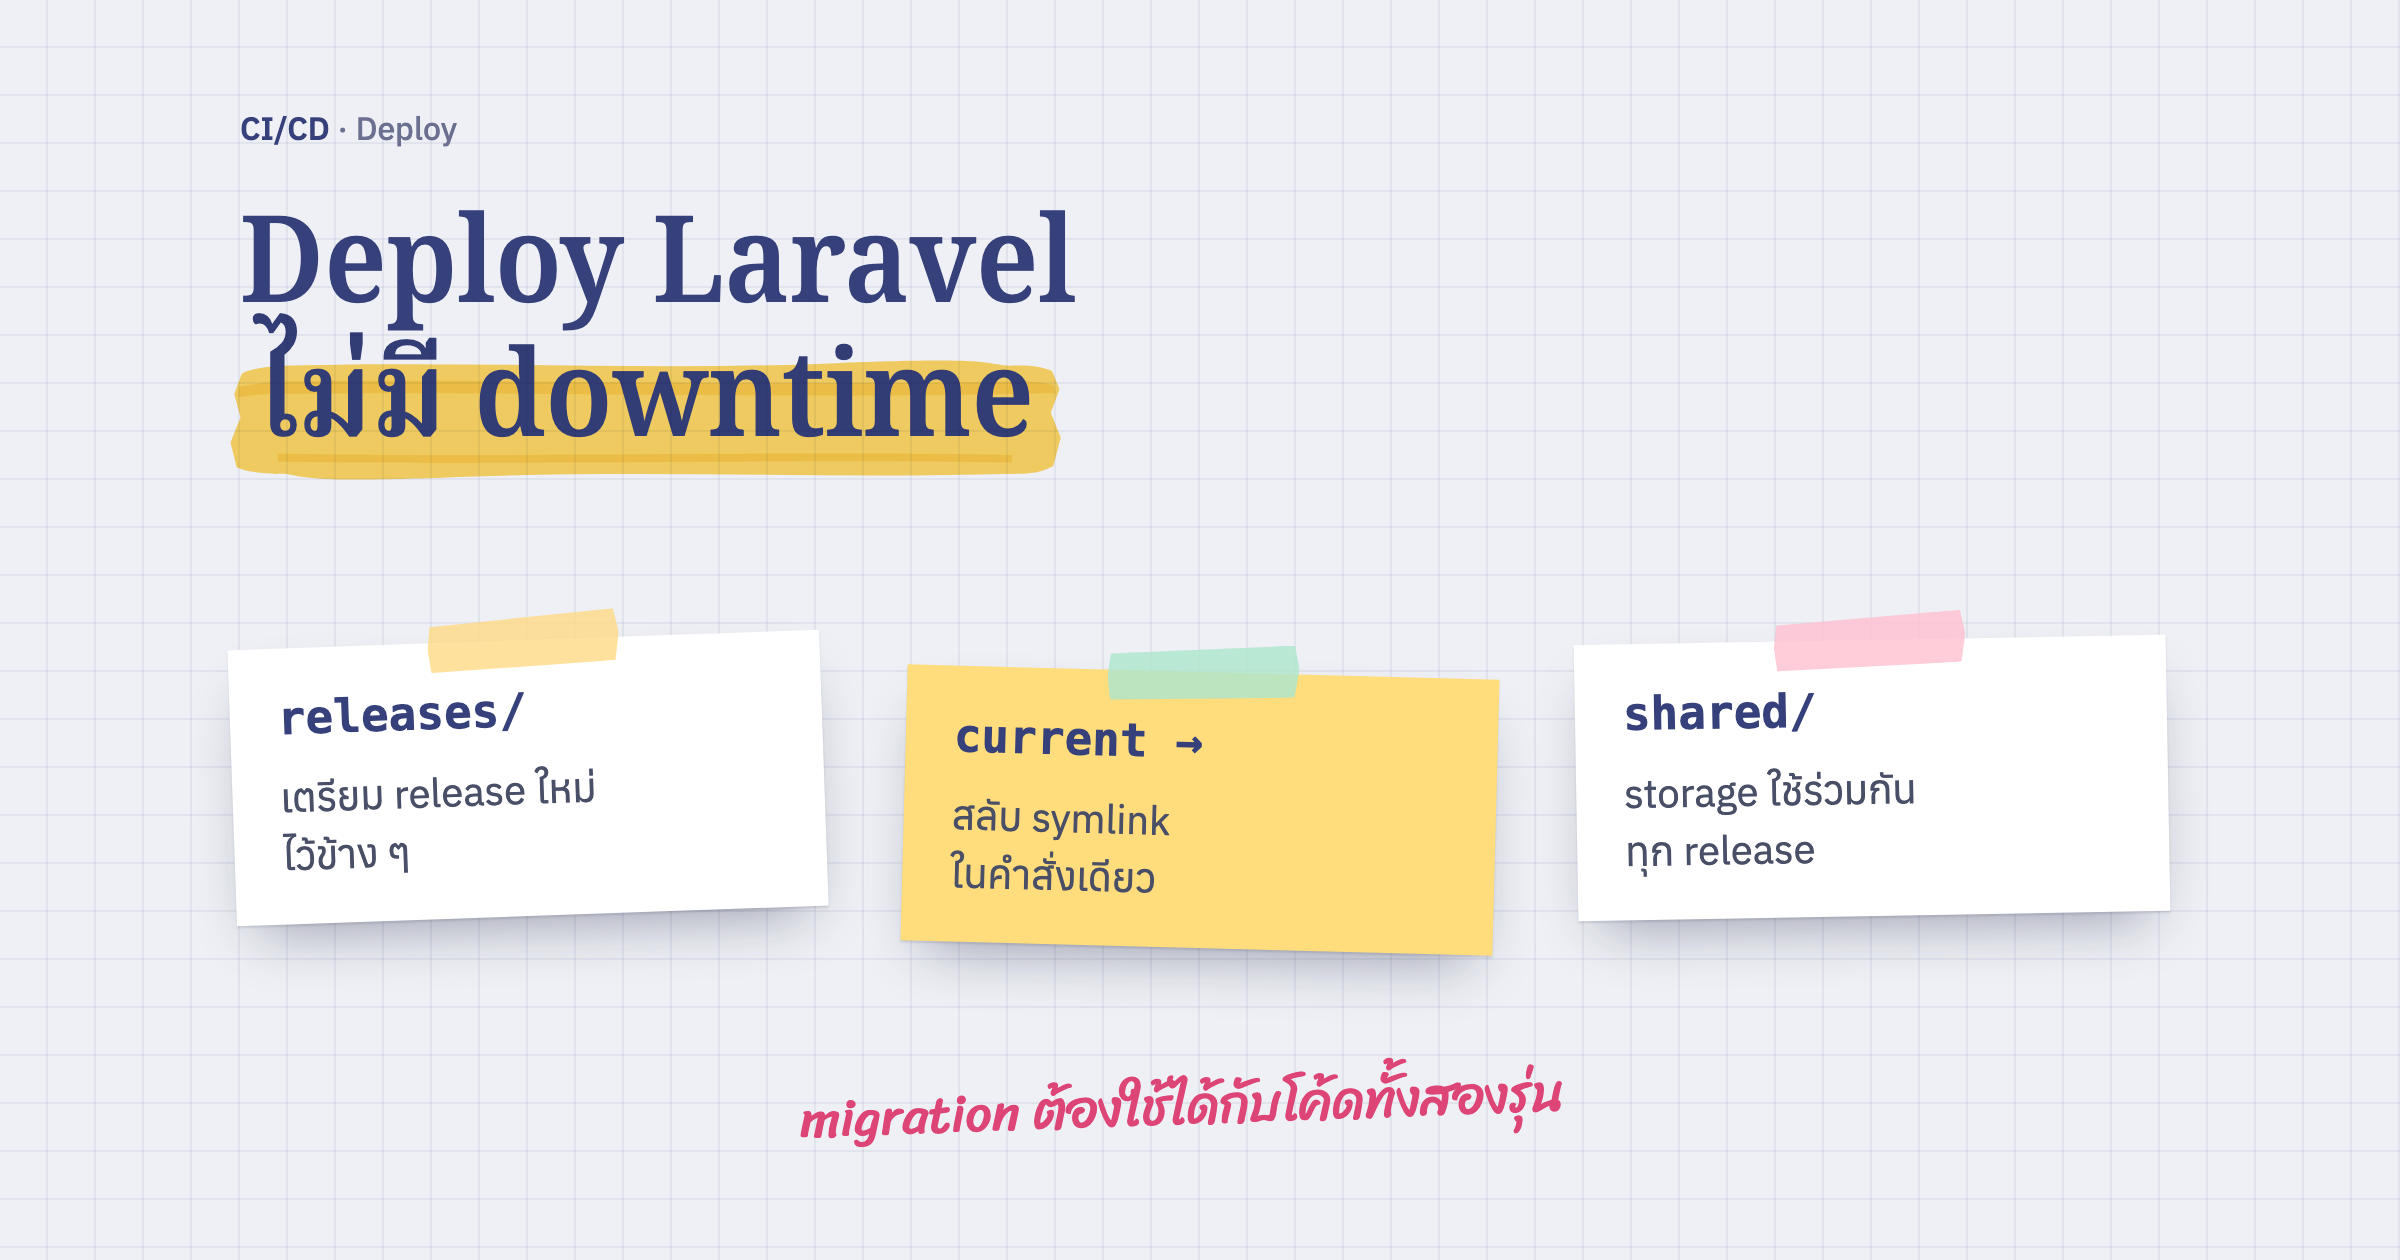
worker โหลดโค้ดและ config เข้า memory ครั้งเดียวตอนเริ่ม ถ้า deploy แล้วไม่สั่งให้เริ่มใหม่ worker จะรันโค้ดเก่ากับ timeout เก่าต่อไปเรื่อย ๆ ต้นฉบับใส่ php artisan horizon:terminate ไว้ในขั้น deploy ให้ Horizon จบงานที่ค้างแล้วออก จากนั้น process manager อย่าง Supervisor หรือ systemd จะเปิดตัวใหม่ขึ้นมาจาก release ใหม่ ถ้ามี queue:work ที่รันแยกไว้ ก็ต้องสั่ง queue:restart แยกด้วย (ดูเรื่อง process ที่รันค้างตอน deploy เพิ่มได้ในโพสต์ deploy แบบไม่มี downtime)
ระบบรายงานตัวเดียวกันของเราเจอว่าขั้นนี้ไม่ได้ทำงานมาหลายเดือนโดยไม่มีใครรู้ horizon:terminate ส่ง signal ไปที่ process หลักของ Horizon แต่ user ที่รัน deploy กับ user ที่รัน Horizon (www-data) เป็นคนละคน ระบบปฏิบัติการไม่ยอมให้ส่ง signal ข้าม user แต่คำสั่งก็ยังจบแบบสำเร็จ deploy จึงขึ้นเขียวทุกครั้ง วันที่เปิดดู Horizon รันต่อเนื่องมาตั้งแต่ก่อน deploy ล่าสุด worker ยังใช้ timeout ค่าเก่าที่สั้นกว่า แล้วฆ่า job รายงานทิ้งกลางทาง
ทางแก้คือรันคำสั่งด้วย user เดียวกับ Horizon (sudo -u www-data php artisan horizon:terminate) หรือสั่ง restart ผ่าน Supervisor หรือ systemd ตรง ๆ แล้วให้ deploy ล้มถ้าขั้นนี้ล้ม หลัง deploy ลองเปิดดูเวลาเริ่มของ process Horizon สักครั้ง ว่าเพิ่งเริ่มจริงหรือเปล่า
ตั้ง waits ให้ตรงกับชื่อ connection และคิวจริง
waits ใน config/horizon.php บอกว่างานในคิวไหนรอได้นานสุดกี่วินาที ก่อน Horizon จะแจ้งเตือน (event LongWaitDetected) key ต้องเป็น connection:queue ที่มีอยู่จริง เช่น redis:default ถ้าพิมพ์ชื่อผิด Horizon ก็แค่ไม่เตือน ไม่มี error ให้เห็น และต้องตั้งช่องทางแจ้งเตือนไว้ใน HorizonServiceProvider ด้วย เช่น Horizon::routeMailNotificationsTo() ต้นฉบับแนะนำให้ลองทำให้คิวช้าจริงสักครั้ง ดูว่าข้อความถึงมือเราไหม
ตัวเลขควรอิงจากว่าคิวนั้นปกติรอนานแค่ไหน ระบบหลังร้านของเว็บขายของออนไลน์ตัวหนึ่งของเราตั้งไว้ไม่เท่ากันตามความเร่งของงาน
| คิว | รอได้ |
|---|---|
| อีเมล, ชำระเงิน | 30 วินาที |
| สร้างรายการขนส่ง | 60 วินาที |
| งานทั่วไป | 120 วินาที |
| ดึงสถานะพัสดุ | 300 วินาที |
ถ้าคิวไหนตั้งใจจำกัดความเร็วไว้ (throttle) งานจะรอนานกว่าปกติอยู่แล้ว ต้องเผื่อตัวเลขให้ และเวลารอในคิวก็บอกได้แค่ว่างานค้าง ไม่ได้บอกว่างานเดินหน้าไปแค่ไหน ต้นฉบับจึงดูความคืบหน้าของแคมเปญคู่กันไปด้วย ส่วน job ที่รันนานเกินกำหนดหลังเริ่มแล้ว Laravel 13.40 มี Queue::whenJobRunsLongerThan() ไว้เตือนอีกทาง
วัดตอนงานเข้าจริงก่อนเปลี่ยนจำนวน worker
พอ config อธิบายได้ทุกบรรทัดแล้ว ต้นฉบับเก็บตัวเลขระหว่างส่งแคมเปญจริง ทุกนาที
- server load, memory ที่เหลือ และ swap
- CPU และ memory ของ worker เทียบกับ PHP-FPM
- จำนวนงานในคิว เทียบกับความคืบหน้าของแคมเปญ
- อัตราส่งอีเมลจริง เทียบกับ throttle ที่ตั้งไว้และ limit ของผู้ให้บริการส่งอีเมล
แล้วอ่านตัวเลขพวกนี้ไปด้วยกัน คิวที่ยาวขึ้นเรื่อย ๆ อาจต้องการ worker เพิ่ม แต่ต้องดูก่อนว่า server มีที่ว่างพอ ถ้า PHP-FPM ยุ่งขณะที่ worker ว่าง ต้นเหตุน่าจะอยู่ที่ request ของหน้าเว็บมากกว่า ต้นฉบับวัดได้ว่าส่งได้จริงราว 0.55 ฉบับต่อวินาที ทั้งที่ตั้ง throttle ไว้ 1 ฉบับต่อวินาที เขาจะเช็ก limit ของผู้ให้บริการส่งอีเมลก่อนจะไปยุ่งกับ throttle
ก่อนเพิ่ม worker ให้คิวไหน ให้ดูด้วยว่าในคิวนั้นมีงานอะไร ระบบรายงานจาก ERP ของเราตั้ง maxProcesses ไว้ 5 ตัว แต่ตัวกลางที่ต่อฐานข้อมูลของ ERP ใช้ connection เดียว query จากทุก worker จึงต้องต่อแถวกันอยู่ดี worker ที่เพิ่มไม่ได้ทำให้ดึงข้อมูลเร็วขึ้นเลย คอขวดอยู่ที่ตัวกลาง ส่วนระบบหลังร้านอีกตัวแยกงานดึงสถานะพัสดุ ซึ่งรอ API ของขนส่งนาน ออกไปเป็น supervisor ของตัวเอง งานชำระเงินกับอีเมลจะได้ไม่ต้องรอ worker ว่างจากงานพัสดุ
วิธีที่ต้นฉบับใช้คือเก็บตัวเลขจากรอบที่เป็นตัวแทนของงานปกติไว้เป็นฐาน เปลี่ยนทีละอย่าง แล้วเทียบตัวเลขเดียวกันในรอบถัดไป และกลับมาดูใหม่เมื่องานยาวขึ้น คนใช้เยอะขึ้น หรือมีงานอื่นมาแชร์ server
กรณีที่อาจเจอเมื่อ worker ตายกลางงาน
ระบบรายงานของเรามีอีกกรณีที่หน้าตาคล้าย timeout แต่ไม่ใช่ worker สร้างไฟล์ Excel ขนาดใหญ่จน memory หมดแล้ว process ตาย job นั้นตั้ง tries = 1 ไว้ พอผ่านไปเท่า retry_after Redis ปล่อยงานกลับเข้าคิว worker ตัวใหม่หยิบไปแล้วเห็นว่าใช้ครบจำนวนครั้งแล้ว จึงขึ้นเป็น MaxAttemptsExceededException ใน failed jobs ซึ่งอ่านแล้วเหมือนงานช้าเกินเวลา ถ้าเจอ exception นี้กับงานหนัก ๆ ให้ดู memory ของ worker ประกอบด้วย ไม่ใช่ขยาย timeout อย่างเดียว
รายละเอียดทั้งหมดและวิธีที่ต้นฉบับเก็บตัวเลขระหว่างส่งแคมเปญ อ่านต่อได้ที่บทความของ Stan Daniëlsครับ