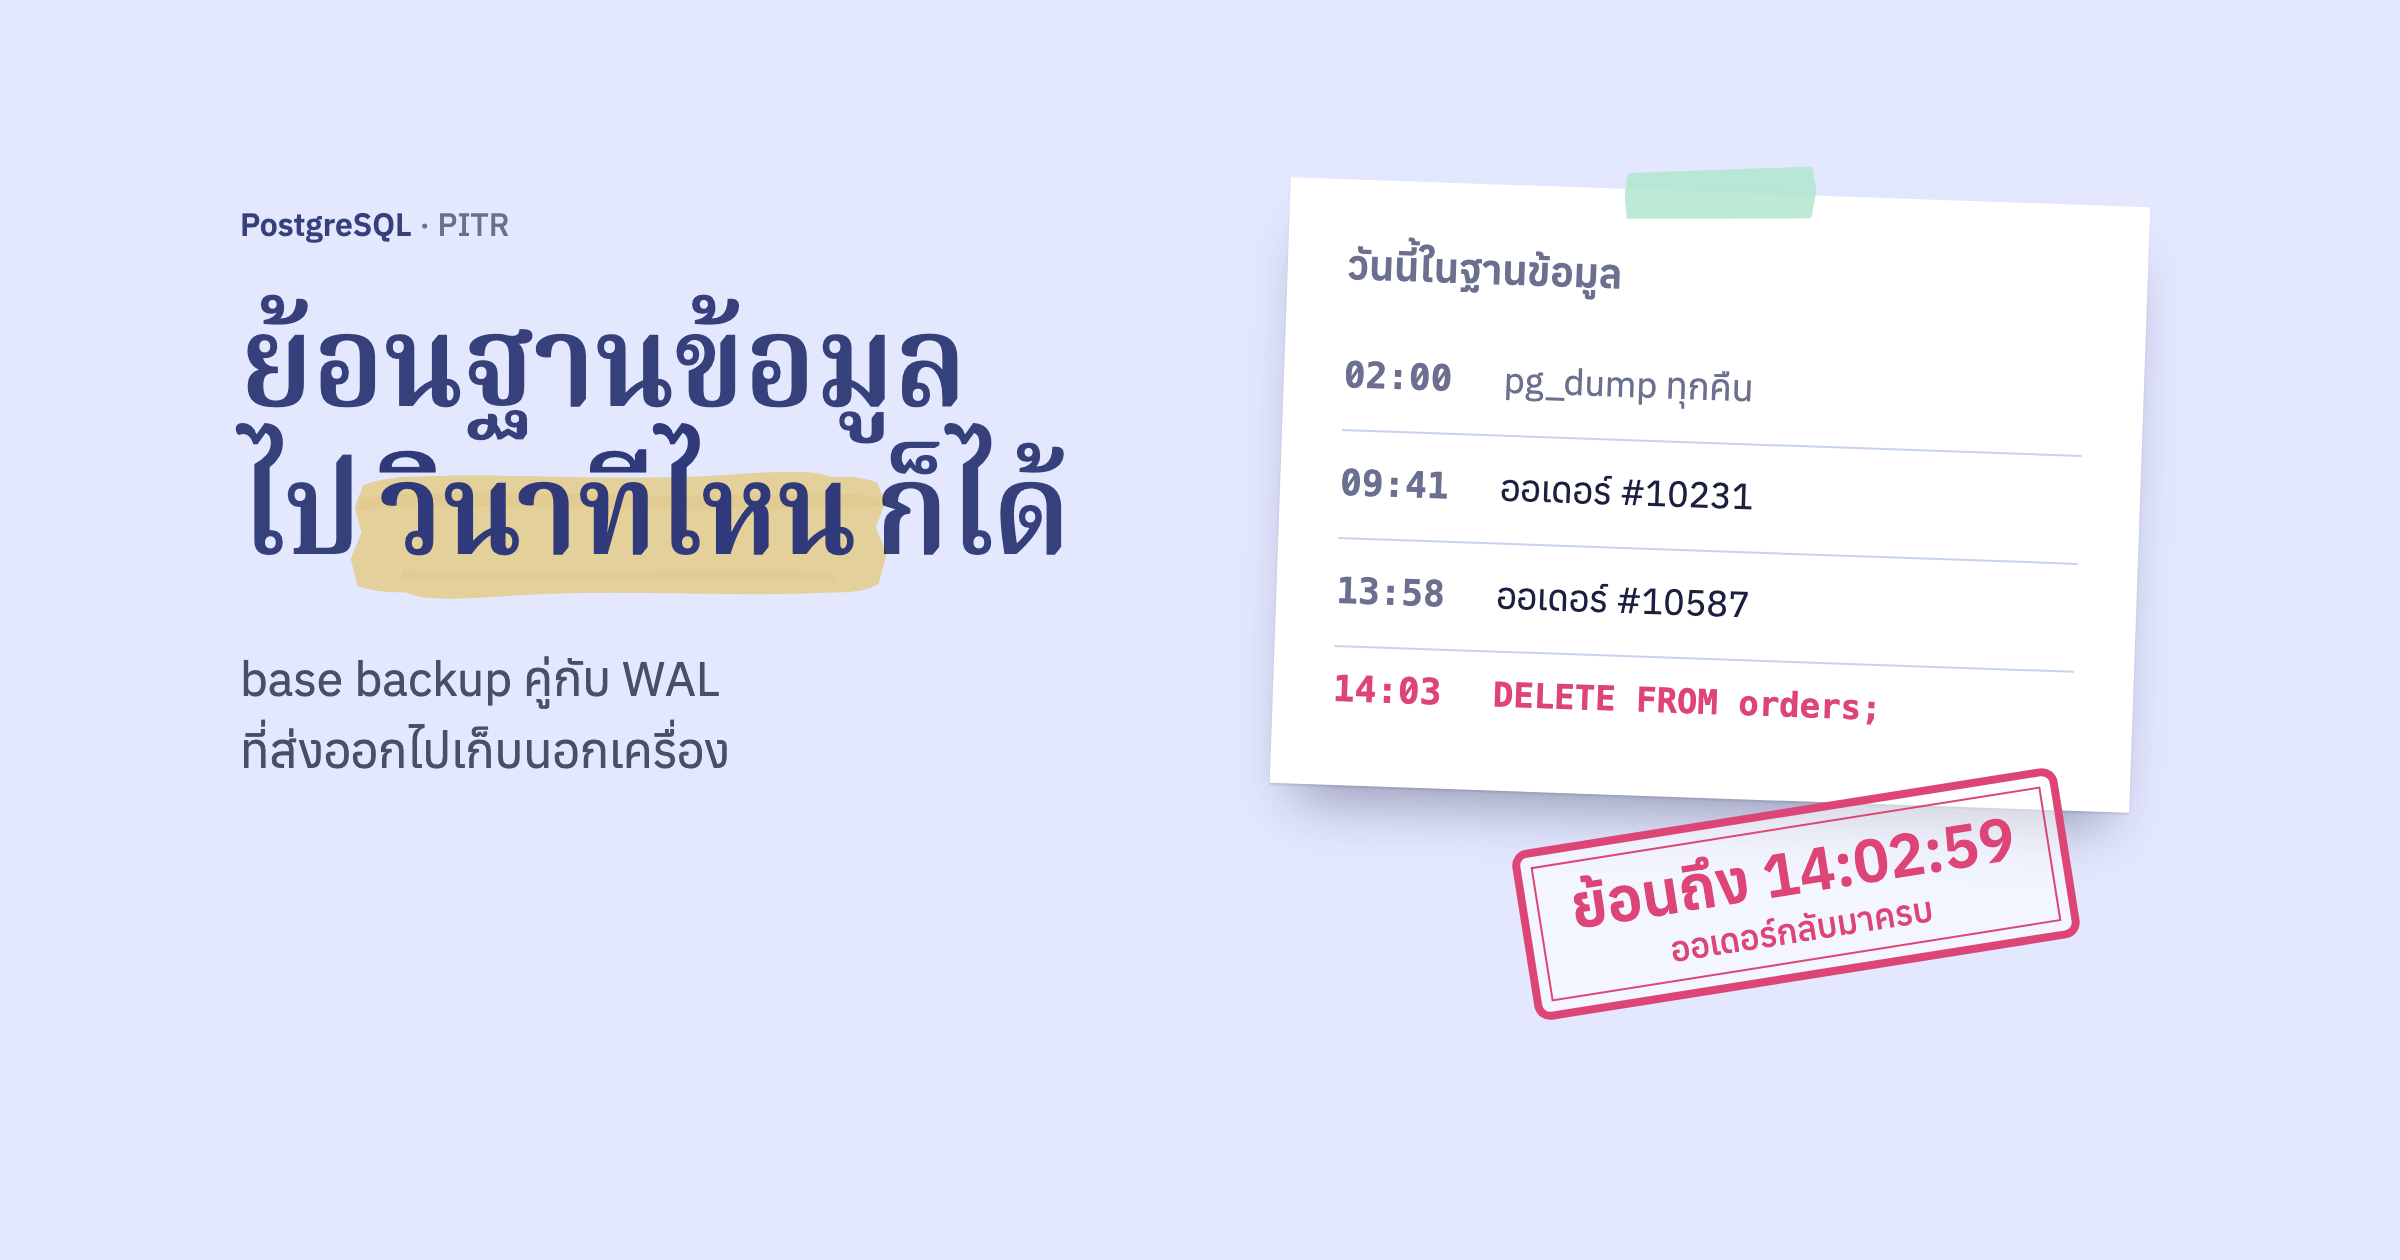
ปกติเราสำรองฐานข้อมูลของแอป Laravel ด้วย pg_dump ตอนตีสองทุกคืน แล้วส่งไฟล์ไปเก็บที่ Google Drive หรือ S3 ก็ถือว่ามี backup แล้ว ทีนี้ลองนึกว่าบ่ายสองโมงสามนาที มีคนรัน DELETE FROM orders ใน console โดยลืม WHERE หรือมี job ที่เขียนผิดลบออเดอร์ทิ้งไปครึ่งตาราง dump ล่าสุดคือของตีสอง ถ้ากู้จากไฟล์นั้น ออเดอร์ที่เข้ามาตลอดสิบสองชั่วโมงก็หายไปด้วย
มี backup กับย้อนกลับไปเวลาไหนก็ได้จึงเป็นคนละเรื่องกัน PostgreSQL มีวิธีทำอย่างหลังมาในตัว เรียกว่า Point-in-Time Recovery หรือ PITR
สัปดาห์นี้ผมเพิ่งแยก role ของฐานข้อมูลในเว็บที่ดูแลอยู่ ให้ role ที่แอปใช้ทำได้แค่อ่านและเขียนข้อมูล แก้ schema ไม่ได้ ถ้า .env หลุดออกไป คนที่ได้ไปก็ DROP TABLE ไม่ได้ แต่ยัง DELETE แถวทิ้งได้อยู่ ช่องที่เหลือนี้คือสิ่งที่ PITR ปิดให้
PITR คืออะไร
PITR คือการกู้ฐานข้อมูลกลับไปยังจุดเวลาที่เราเลือก ละเอียดถึงระดับ transaction จะย้อนไป 14:02:59 วันนี้ หรือ 09:15:30 เมื่อวานก็ได้ ขอให้อยู่ในช่วงที่เก็บของไว้
ลองนึกภาพว่า base backup คือรูปถ่ายของฐานข้อมูลทั้งก้อนตอนตีสอง ส่วน WAL คือวิดีโอที่อัดทุกการเปลี่ยนแปลงต่อจากนั้น ตอนกู้ PostgreSQL เริ่มจากรูปถ่าย แล้วเปิดวิดีโอเล่นไปเรื่อย ๆ จนถึงวินาทีที่เราสั่งให้หยุด
WAL ที่อยู่บนเครื่องยังย้อนเวลาไม่ได้
WAL (Write-Ahead Log) คือบันทึกที่ PostgreSQL เขียนก่อนทุกครั้งที่ข้อมูลเปลี่ยน ก่อนจะไปแก้ไฟล์ข้อมูลจริง มีไว้สองเรื่องหลัก
- กันข้อมูลหายตอนเครื่องดับ ถ้าไฟดับกลางคัน ตอนเปิดเครื่องใหม่ PostgreSQL จะเล่น WAL ซ้ำจนไฟล์ข้อมูลกลับมาครบ
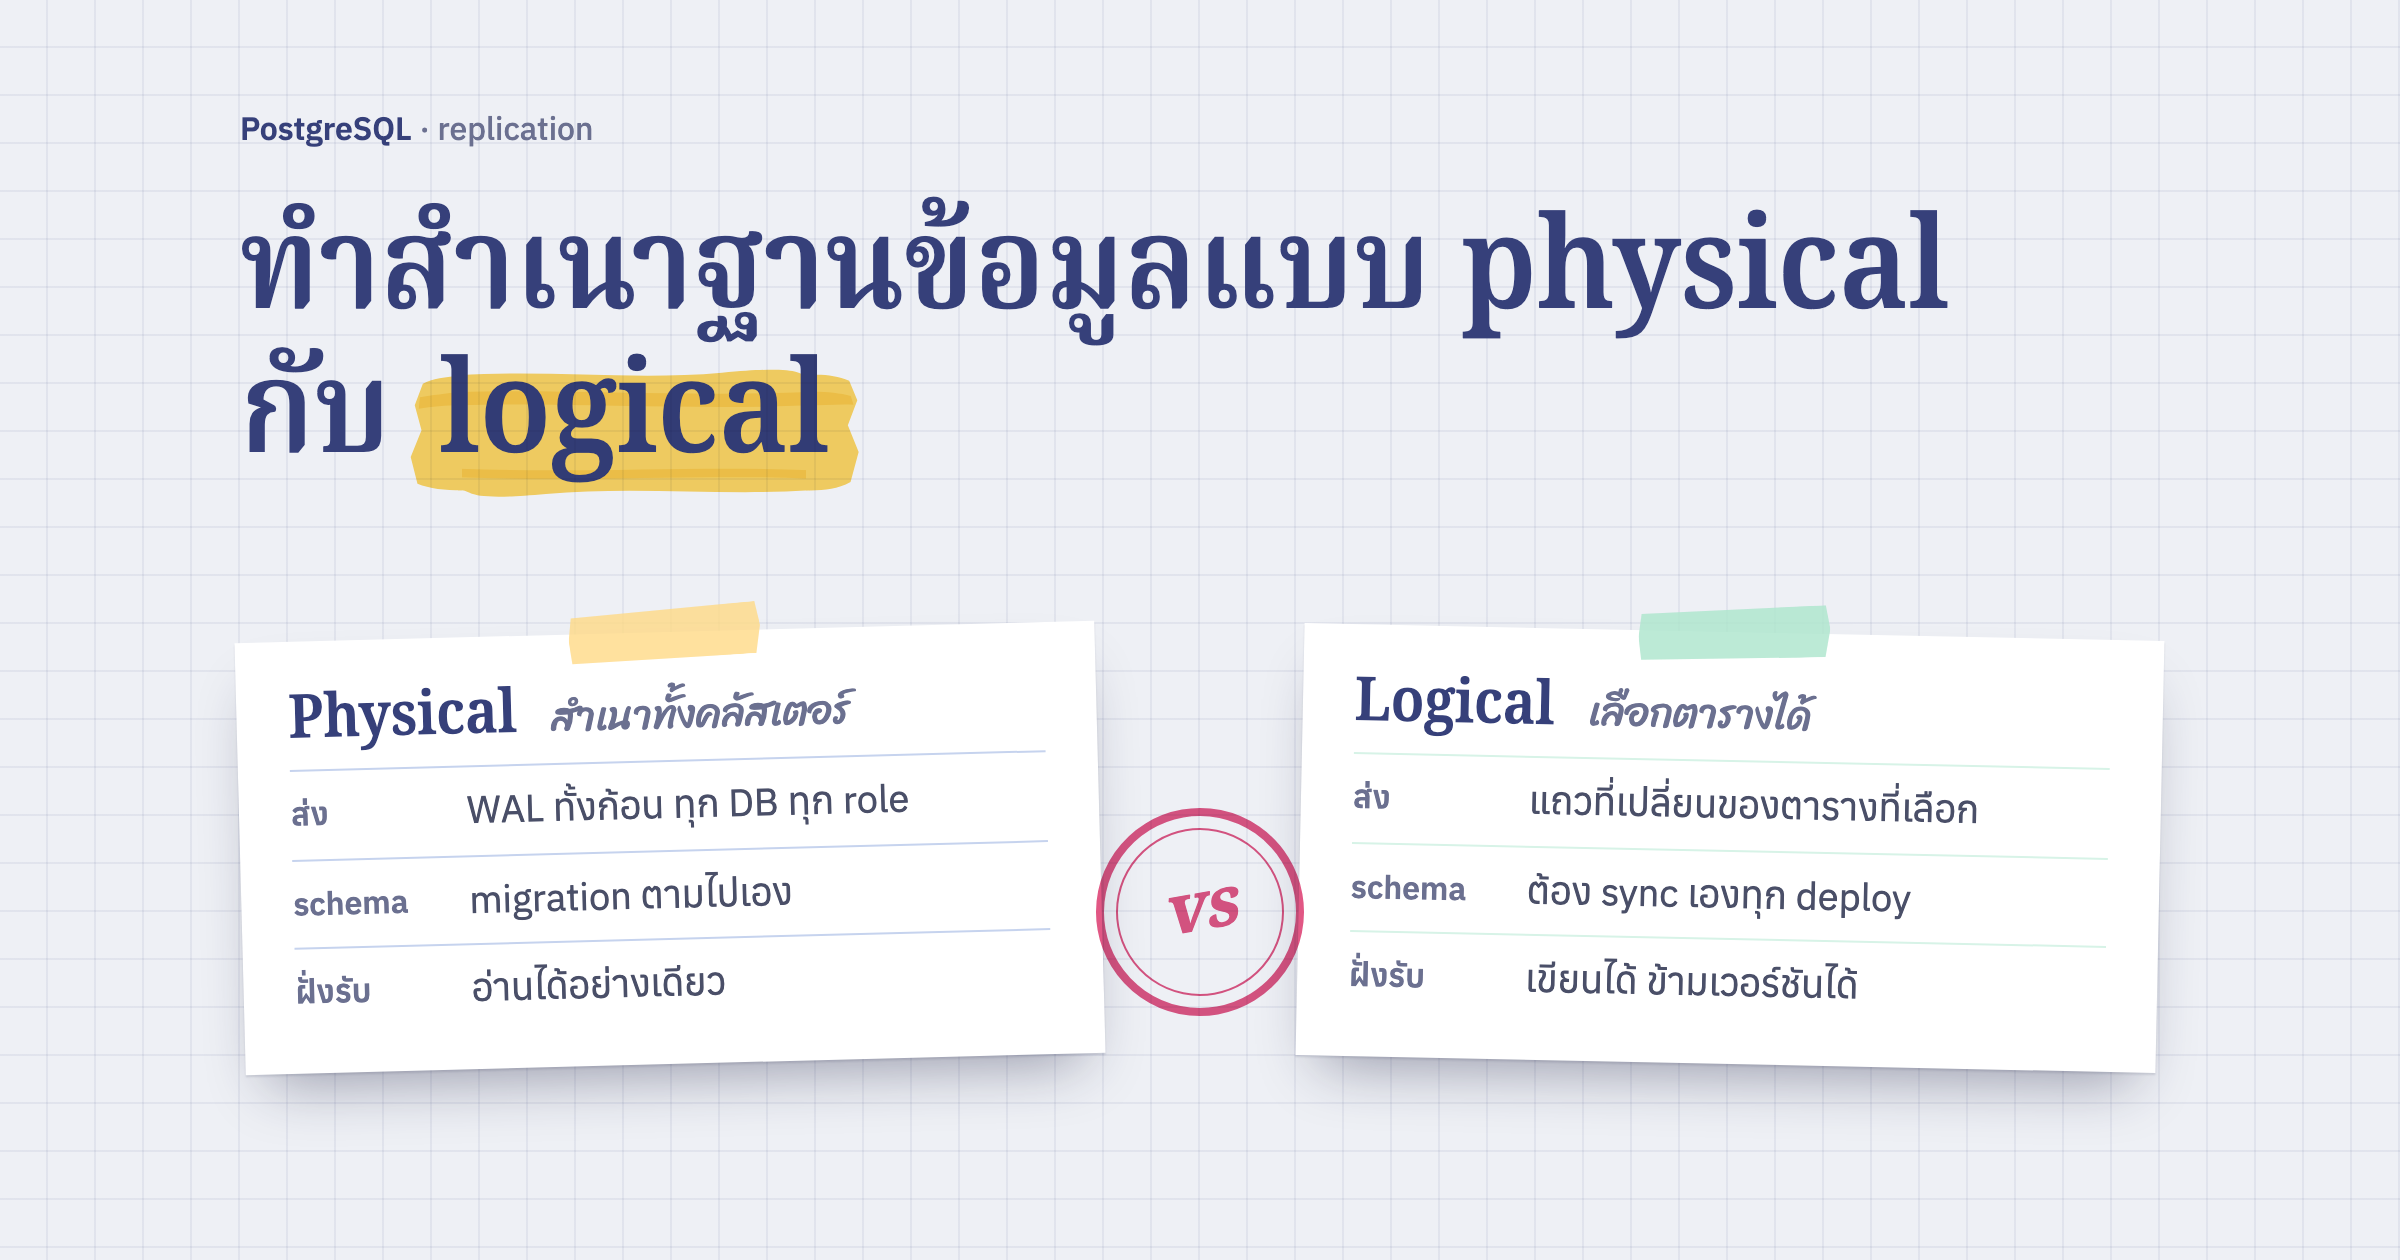
- ทำ replication standby แบบ physical รับ WAL ไปเล่นซ้ำจนได้สำเนาเดียวกับเครื่องหลัก รายละเอียดอยู่ในโพสต์เรื่อง physical กับ logical replication
WAL เก็บเป็นไฟล์ละ 16MB ในโฟลเดอร์ pg_wal แต่ไม่ได้เก็บไว้ตลอด ทุกครั้งที่ checkpoint เขียนข้อมูลจาก memory ลงไฟล์ข้อมูลจนครบ WAL ที่เก่ากว่าจุดนั้นก็ไม่จำเป็นสำหรับกู้ตอนเครื่องดับแล้ว PostgreSQL จึงลบหรือเอาไฟล์นั้นกลับมาใช้ซ้ำ (WAL Configuration) ขนาดรวมของ pg_wal จะวนอยู่แถว max_wal_size ซึ่งค่าเริ่มต้นคือ 1GB
ถ้า archive_mode เป็น off ซึ่งเป็นค่าเริ่มต้น pg_wal จึงมีแค่ WAL ช่วงล่าสุดไม่นาน และอยู่บนดิสก์เดียวกับฐานข้อมูล ดิสก์พังเมื่อไหร่ก็หายไปพร้อมกัน ย้อนเวลาด้วย WAL ชุดนี้ไม่ได้
อีกค่าที่ต้องดูคือ wal_level ซึ่งต้องเป็น replica ขึ้นไป WAL จึงจะมีข้อมูลพอให้กู้ ค่าเริ่มต้นใน PostgreSQL 18 เป็น replica อยู่แล้ว (Write Ahead Log settings) ถ้าไม่เคยแก้ก็ไม่ต้องทำอะไร
pg_dump ทุกคืนกับ PITR ต่างกันตรงไหน
pg_dump อ่านข้อมูลของฐานข้อมูลหนึ่งออกมาเป็นไฟล์ ณ ตอนที่รัน ส่วน PITR ทำงานกับไฟล์ข้อมูลระดับ byte ของทั้งคลัสเตอร์ (server หนึ่งตัวกับทุกฐานข้อมูลข้างใน)
pg_dump ทุกคืน |
PITR | |
|---|---|---|
| กู้ได้ถึง | ตอนที่ dump ล่าสุด | วินาทีไหนก็ได้ในช่วงที่เก็บไว้ |
| ข้อมูลที่อาจเสีย | เกือบ 24 ชั่วโมง | ราวหนึ่งนาทีหรือน้อยกว่า แล้วแต่ตั้ง |
| ขอบเขต | ฐานข้อมูลเดียว หรือบางตาราง | ทั้งคลัสเตอร์ |
| ย้ายไปเครื่องอื่น | กู้ลง PostgreSQL รุ่นใหม่กว่าได้ ดึงลงเครื่อง dev ได้ | ต้องเป็น PostgreSQL major เดียวกัน |
| ใช้ทำอะไร | ย้ายเครื่อง อัปเกรด เก็บระยะยาว | กู้ตอนเครื่องพังหรือคนพลาด |
เวลาคุยเรื่อง backup กับเจ้าของระบบ มีสองตัวเลขที่ควรตกลงกันตั้งแต่แรก
- RPO (Recovery Point Objective) คือยอมเสียข้อมูลย้อนหลังได้นานแค่ไหน
pg_dumpตีสองทุกคืนได้ RPO สูงสุดเกือบ 24 ชั่วโมง ส่วน PITR เสียแค่ส่วนที่ยังไม่ได้ส่ง WAL ออกไป - RTO (Recovery Time Objective) คือยอมให้ระบบหยุดได้นานแค่ไหนกว่าจะกลับมา สำหรับ PITR ขึ้นกับขนาด base backup กับปริมาณ WAL ที่ต้องเล่นต่อ base backup ยิ่งเก่า WAL ที่ต้องเล่นก็ยิ่งยาว
เว็บขายของออนไลน์ที่ออเดอร์เข้าทั้งวัน เสียข้อมูลครึ่งวันคือต้องไล่โทรหาลูกค้าทีละคน ตัวเลขสองตัวนี้จะบอกว่าแค่ pg_dump ทุกคืนพอหรือยัง
PITR ต้องมี base backup และ WAL ที่ส่งออกนอกเครื่อง
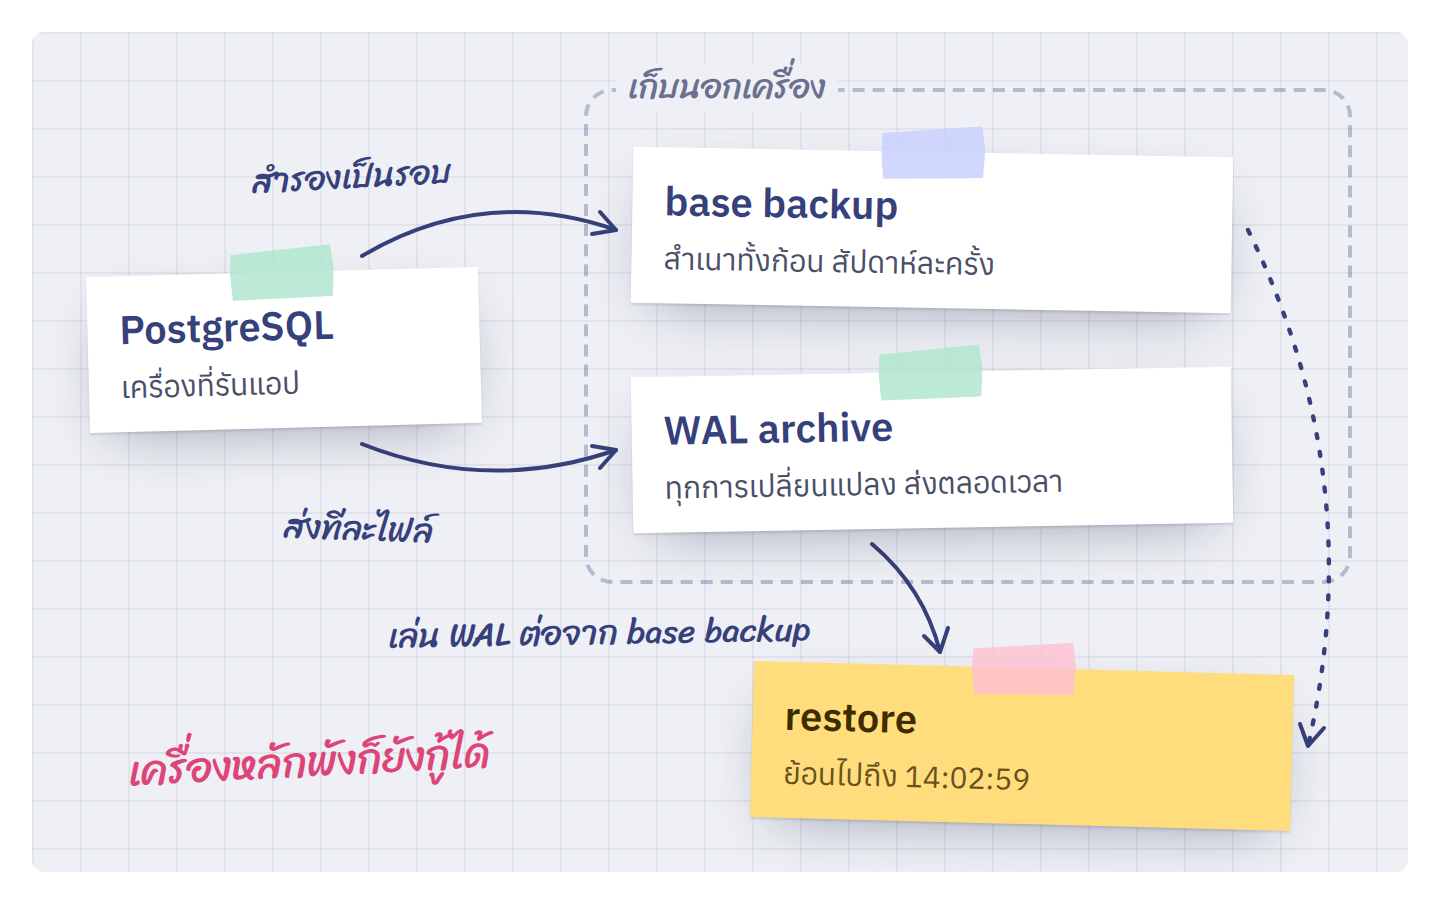
base backup เป็นจุดเริ่ม WAL archive คือทุกอย่างที่เกิดหลังจากนั้น ทั้งสองอย่างต้องอยู่นอกเครื่องที่รันฐานข้อมูล
1. base backup คือสำเนาไฟล์ข้อมูลทั้งคลัสเตอร์ที่ทำได้ตอนฐานข้อมูลยังรันอยู่ ไม่ต้องหยุดระบบ ใช้ pg_basebackup ที่มากับ PostgreSQL หรือเครื่องมืออย่าง pgBackRest และ wal-g ก็ได้ ตั้งแต่ PostgreSQL 17 pg_basebackup ทำ incremental backup ได้ด้วย โดยใช้ --incremental แล้วรวมกลับด้วย pg_combinebackup ซึ่งต้องเปิด summarize_wal ไว้ก่อน (pg_basebackup)
2. WAL archiving คือให้ PostgreSQL ส่ง WAL ทุกไฟล์ที่เขียนเต็มแล้วออกไปเก็บ ก่อนจะลบหรือใช้ไฟล์นั้นซ้ำ เปิดด้วย archive_mode = on แล้วบอกวิธีส่งด้วย archive_command (คำสั่ง shell) หรือ archive_library (module ที่โหลดเข้า PostgreSQL) เลือกอย่างใดอย่างหนึ่ง ถ้าตั้งทั้งคู่ PostgreSQL จะ error (Continuous Archiving)
ปลายทางต้องอยู่นอกเครื่อง เช่น object storage แบบ S3 หรือเครื่องอื่นผ่าน SFTP ถ้าเก็บไว้ดิสก์เดียวกัน วันที่ดิสก์พังก็เสียทั้ง base backup และ WAL ไปพร้อมกัน
ค่าที่ต้องตั้งมีไม่กี่บรรทัด ตัวอย่างนี้ใช้ pgBackRest ส่ง WAL
wal_level = replica      # ค่าเริ่มต้นอยู่แล้ว
archive_mode = on        # เปลี่ยนแล้วต้องรีสตาร์ต
archive_command = 'pgbackrest --stanza=myapp archive-push %p'
archive_timeout = 60     # ส่งไฟล์อย่างช้าทุก 60 วินาที แม้ยังเขียนไม่เต็ม
archive_timeout กันไม่ให้ WAL ค้างอยู่บนเครื่องนานเกินไปตอนที่ระบบเขียนน้อย แต่ไฟล์ที่ปิดก่อนเต็มยังมีขนาด 16MB เท่าเดิม docs จึงเตือนว่าตั้งสั้นเกินไปจะเปลืองที่เก็บ ราวหนึ่งนาทีมักกำลังดี (Write Ahead Log settings)
ถ้าส่ง WAL ไม่สำเร็จ PostgreSQL จะเก็บไฟล์ไว้แล้วลองส่งใหม่เรื่อย ๆ ไม่ลบทิ้ง ข้อมูลจึงปลอดภัย แต่ถ้าปลายทางล่มหลายวัน pg_wal จะโตจนดิสก์เต็ม แล้ว PostgreSQL จะหยุดทำงาน (PANIC shutdown) เว็บก็ล่มตามไปด้วย จึงต้องมีตัวเฝ้าดู เช่นดู failed_count กับ last_archived_time ใน view pg_stat_archiver แล้วแจ้งเตือนเมื่อไม่มีไฟล์ส่งออกไปนานเกินไป
ย้อนกลับไปก่อน DELETE ตอน 14:03
ตอนกู้ เราเอา base backup ชุดที่ทำก่อนเวลาที่ต้องการมาวางเป็น data directory แล้วบอก PostgreSQL สามอย่าง
- ดึง WAL จาก archive ด้วยคำสั่งอะไร (
restore_command) - หยุดที่เวลาไหน (
recovery_target_time) - ให้เริ่มโหมดกู้ โดยสร้างไฟล์ว่างชื่อ
recovery.signalไว้ใน data directory
restore_command = 'pgbackrest --stanza=myapp archive-get %f "%p"'
recovery_target_time = '2026-11-12 14:02:59+07'
ใส่ timezone เป็นตัวเลขอย่าง +07 ไว้เสมอ docs แนะนำแบบนี้มากกว่าตัวย่อ timezone (Recovery Target) pgBackRest ทำสามข้อนี้ให้ในคำสั่ง restore --type=time คำสั่งเดียว ส่วน wal-g ใช้ wal-g wal-fetch ใส่ใน restore_command
พอเล่น WAL ถึงเวลาที่ตั้ง ค่าเริ่มต้นของ PostgreSQL คือหยุดรอ (recovery_target_action = pause) ให้เราเข้าไปดูข้อมูลก่อนว่าใช่จุดที่ต้องการ ถ้ายังเร็วไปหรือช้าไป ก็ปรับเวลาแล้วกู้ใหม่ได้
ทีนี้มีเรื่องหนึ่งที่ต้องคิด PITR ย้อนทั้งคลัสเตอร์ ถ้ากู้ทับเครื่องหลัก ออเดอร์ที่เข้ามาหลัง 14:03 ซึ่งไม่เกี่ยวกับการลบก็หายไปด้วย กรณีคนพลาดลบข้อมูล ทางที่เสียน้อยกว่าคือกู้ลงอีกเครื่องแล้วดึงเฉพาะแถวที่หายกลับมา ส่วนกรณีเครื่องพังทั้งเครื่อง ก็กู้ไปจนถึง WAL ไฟล์สุดท้ายที่มี
ถ้ารู้ล่วงหน้าว่ากำลังจะทำอะไรเสี่ยง เช่น deploy ที่มี migration ย้ายข้อมูล ก็สร้างจุดที่มีชื่อไว้ก่อนด้วย SELECT pg_create_restore_point('before_deploy_v42'); แล้วตอนกู้ใช้ recovery_target_name แทนเวลา ไม่ต้องเดาวินาที (Backup Control Functions) ฟังก์ชันนี้ใช้ได้เฉพาะ superuser ถ้าไม่ได้ให้สิทธิ์เพิ่ม role ของแอปจึงเรียกเองไม่ได้ ต้องสั่งจากขั้น deploy ที่ใช้ role เจ้าของฐานข้อมูล
เลือกระหว่าง pgBackRest, wal-g หรือเขียน archive_command เอง
archive_command + pg_basebackup |
pgBackRest | wal-g | |
|---|---|---|---|
| ติดตั้ง | มากับ PostgreSQL | ลง package เพิ่ม | binary ตัวเดียว |
| ปลายทาง | เขียนเอง เช่น rsync ไปอีกเครื่อง |
S3, Azure, GCS, SFTP, โฟลเดอร์ | S3, GCS, Azure, SSH, โฟลเดอร์ และอื่น ๆ |
| ลบของเก่าตามรอบ | เขียนเอง | repo1-retention-full |
delete retain |
| จุดเด่น | ไม่ต้องลงอะไรเพิ่ม | full, differential, incremental บีบอัด เข้ารหัส มีคำสั่ง check |
delta backup และใช้กับ MySQL/MariaDB ได้ด้วย |
- เขียน
archive_commandเอง ไม่ต้องลงอะไรเพิ่ม แต่งานที่เหลือเราต้องทำเองทั้งหมด docs เขียนเงื่อนไขไว้ละเอียด เช่น คำสั่งต้องคืนค่า 0 เฉพาะตอนเก็บไฟล์สำเร็จจริง และไม่ควรเขียนทับไฟล์ที่มีอยู่แล้ว ยังไม่นับงานลบ WAL เก่าที่ไม่มี base backup ไหนต้องใช้แล้ว พลาดตรงไหนก็มารู้ตอนจะกู้ เหมาะกับลองเพื่อเข้าใจกลไกมากกว่า - pgBackRest ครบที่สุดสำหรับ PostgreSQL ส่งไฟล์ขนานกันได้หลายตัว และมีคำสั่ง
checkไว้ทดสอบว่าส่ง WAL ได้จริง รุ่นล่าสุดตอนเขียนคือ 2.60.0 ออกเมื่อ 18 ต.ค. 2569 รองรับ PostgreSQL 18 - wal-g ตั้งค่าผ่าน environment variable ใช้ได้ทั้ง PostgreSQL, MySQL/MariaDB และ SQL Server เหมาะถ้าดูแลฐานข้อมูลหลายแบบแล้วอยากใช้เครื่องมือตัวเดียว
สำหรับ VPS เครื่องเล็กที่มีฐานข้อมูลเดียว ผมว่า pgBackRest ส่งไปเก็บที่ object storage ตั้งง่ายและครอบคลุมพอ ทั้งสองตัวเป็น open source ค่าใช้จ่ายหลักจึงเป็นค่าที่เก็บไฟล์
ระยะย้อนหลังกับค่าที่เก็บ
ย้อนได้ไกลแค่ไหนขึ้นกับ base backup ที่เก่าที่สุดที่ยังเก็บไว้ บวก WAL ต่อจากนั้นซึ่งต้องครบทุกไฟล์ ขาดไฟล์เดียวก็เล่นต่อไม่ได้ ถ้าทำ full backup ทุกวันอาทิตย์และเก็บไว้สองชุด (repo1-retention-full=2 ใน pgBackRest) ก็ย้อนได้ราวหนึ่งถึงสองสัปดาห์ เพิ่ม differential ทุกคืนอีกชั้น ตอนกู้ก็เล่น WAL น้อยลง RTO สั้นลงตาม
ปริมาณ WAL ขึ้นกับว่าระบบเขียนข้อมูลมากแค่ไหน ไม่ได้ขึ้นกับขนาดฐานข้อมูล ฐานข้อมูล 2GB ที่ออเดอร์เข้าทั้งวันอาจสร้าง WAL มากกว่าฐานข้อมูล 50GB ที่แทบไม่มีใครแก้ วิธีประเมินที่ง่ายที่สุดคือเปิด archive ไว้สักสัปดาห์ ดูว่าปลายทางโตวันละเท่าไหร่ คูณด้วยจำนวนวันที่อยากย้อน แล้วบวกขนาด full backup ที่เก็บไว้
ซ้อม restore ทุกเดือน
backup ที่ไม่เคยลองกู้ ยังบอกไม่ได้ว่าใช้ได้จริง docs ของ PostgreSQL เองก็ให้ตั้งและทดสอบขั้นตอน archive ก่อนทำ base backup ชุดแรก ปัญหาที่เจอได้มีตั้งแต่ WAL ขาดไปบางไฟล์ หารหัสผ่านของ repository ที่เข้ารหัสไว้ไม่เจอ ไปจนถึงกู้จริงแล้วใช้เวลานานกว่าที่คิดไว้มาก
ซ้อมแบบง่าย ๆ คือเดือนละครั้ง กู้ลงเครื่องหรือ data directory แยก ไปยังเวลาหนึ่งเมื่อวาน แล้วเช็คว่า
- ออเดอร์ล่าสุดในฐานข้อมูลที่กู้มามีเวลาตรงกับจุดที่สั่งหยุด
- ใช้เวลากู้นานแค่ไหน ตัวเลขนี้คือ RTO จริงของระบบ
- ขั้นตอนที่จดไว้ทำตามได้ครบ ไม่ต้องพึ่งความจำ
ฝั่ง pg_dump ผมใช้ snapshot:drill จากแพ็กเกจ db-snapshot-sync-laravel ซ้อมให้ทุกเดือน คำสั่งนี้ดาวน์โหลดสำเนาจากนอกเครื่องมา restore ลงฐานข้อมูลชั่วคราว แล้วเทียบจำนวนแถวกับของจริง ฝั่ง PITR ก็ใช้แนวคิดเดียวกันได้
เก็บ pg_dump ไว้ใช้คู่กับ PITR
ถึงจะเปิด PITR แล้ว pg_dump ก็ยังมีที่ใช้ของตัวเอง
- กู้ลง PostgreSQL รุ่นใหม่กว่าได้ จึงใช้ตอนอัปเกรด major version หรือย้ายเครื่อง
- ดึงข้อมูลลงเครื่อง dev หรือกู้แค่บางตารางได้ ซึ่ง base backup ทำไม่ได้
- เก็บไฟล์รายเดือนไว้นาน ๆ ได้ในราคาถูก โดยไม่ต้องเก็บ WAL ทั้งปี
PITR จึงเป็นอีกชั้นที่ซ้อนขึ้นมา ใช้ย้อนเวลาตอนเครื่องพังหรือคนพลาด แผนที่พอดีกับเว็บส่วนใหญ่คือ pg_dump ทุกคืนเหมือนเดิม บวก base backup ทุกสัปดาห์กับ WAL archive ที่ส่งตลอดเวลา แล้วซ้อมกู้ทั้งสองแบบ
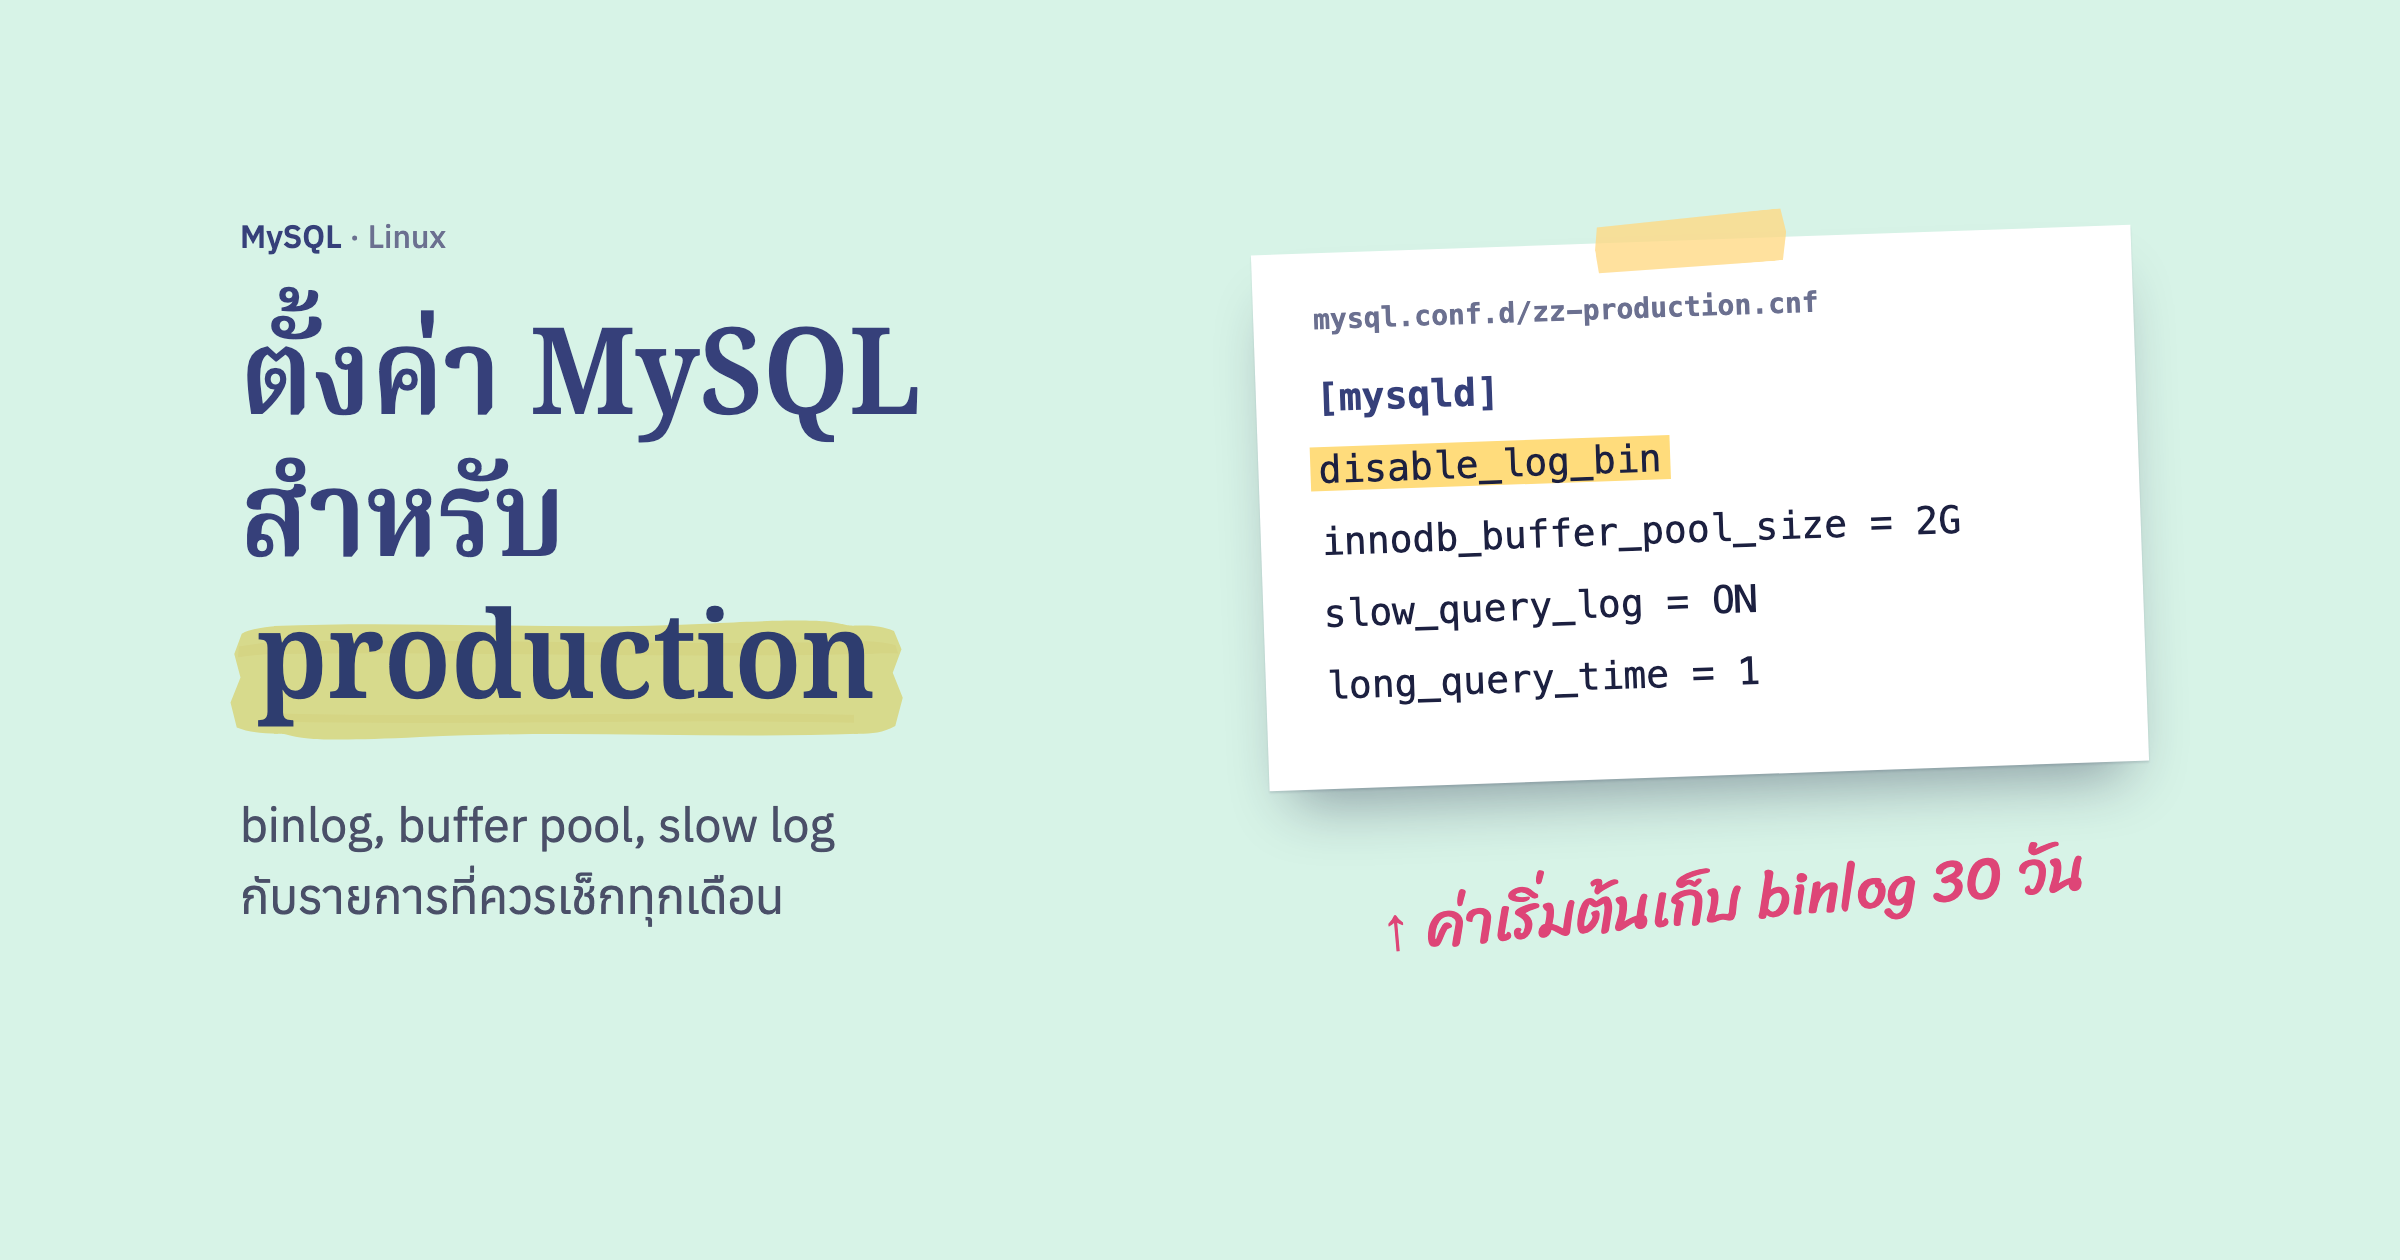
ฝั่ง MySQL ก็ใช้แนวคิดเดียวกัน คือ full backup คู่กับ binary log (binlog) แล้วเล่น binlog ต่อด้วย mysqlbinlog จนถึงตำแหน่งก่อนคำสั่งที่พลาด docs แนะนำให้หยุดด้วย --stop-position มากกว่า --stop-datetime เพราะการกำหนดด้วยเวลาอาจพลาด event บางตัวไป (Point-in-Time Recovery Using Event Positions) MySQL 8.4 เปิด binlog ไว้เป็นค่าเริ่มต้น แต่ต้องส่งไฟล์ออกนอกเครื่องเองเหมือนกัน ค่าที่เกี่ยวกับ binlog อ่านต่อได้ในโพสต์ตั้งค่า MySQL 8.4 สำหรับ production