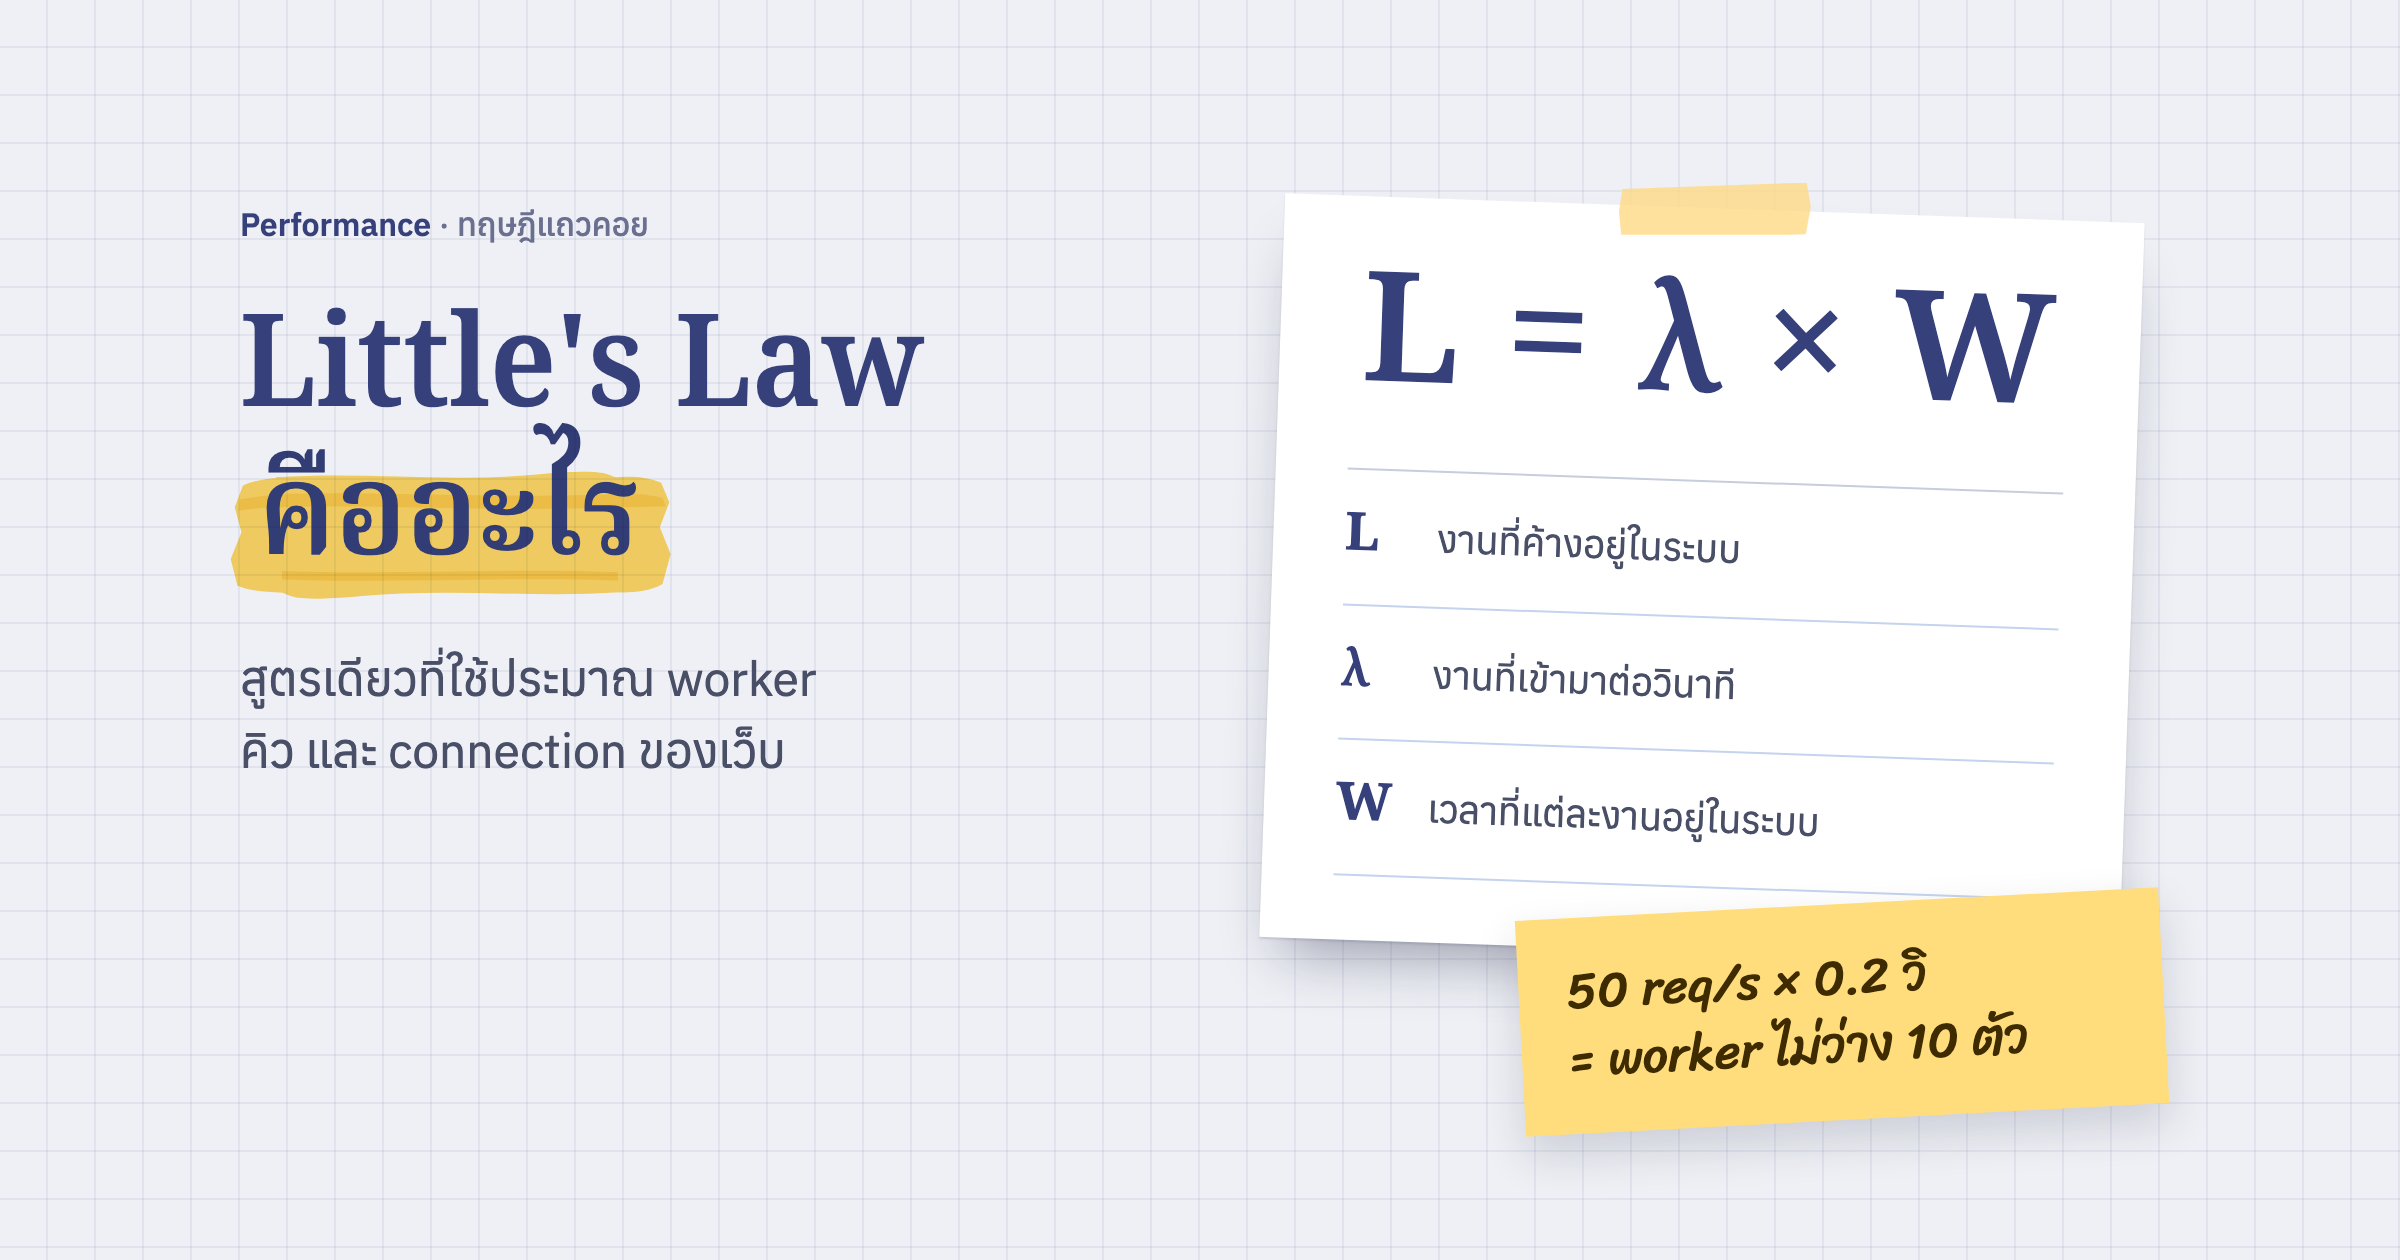
สูตรมีแค่ L = λW
Little's Law เป็นสูตรจากทฤษฎีแถวคอย (queueing theory) ที่ใช้กับอะไรก็ได้ที่มีของเข้ามา อยู่สักพัก แล้วออกไป เช่น ลูกค้าในร้าน รถบนทางด่วน หรือ request ในเว็บเรา
- L คือจำนวนงานที่อยู่ในระบบโดยเฉลี่ย นับทั้งที่กำลังทำและที่รอคิว
- λ (อ่านว่า แลมบ์ดา) คือจำนวนงานที่เข้ามาต่อหน่วยเวลาโดยเฉลี่ย เช่น request ต่อวินาที
- W คือเวลาเฉลี่ยที่งานหนึ่งอยู่ในระบบ ตั้งแต่เข้ามาจนออกไป
ลองนึกถึงร้านกาแฟที่มีลูกค้าเข้า 30 คนต่อชั่วโมง แต่ละคนนั่งอยู่ราว 20 นาที (หนึ่งในสามชั่วโมง) ในร้านจะมีลูกค้าเฉลี่ย 30 × ⅓ = 10 คน ถ้าอยากรับลูกค้าเพิ่มเป็น 60 คนต่อชั่วโมงโดยมีที่นั่งเท่าเดิม ลูกค้าแต่ละคนก็ต้องนั่งสั้นลงเหลือ 10 นาที ไม่อย่างนั้นร้านก็ต้องมีที่นั่งเพิ่มเป็น 20 ที่
สูตรนี้ Philip M. Morse เป็นคนตั้งไว้ แล้วท้าให้คนอ่านหากรณีที่สูตรไม่จริง John D. C. Little พิสูจน์ไว้ในวารสาร Operations Research ปี 1961 ว่าไม่มีกรณีแบบนั้น สูตรจึงได้ชื่อตามเขา (Wikipedia สรุปประวัติและตัวอย่างไว้ครบ)
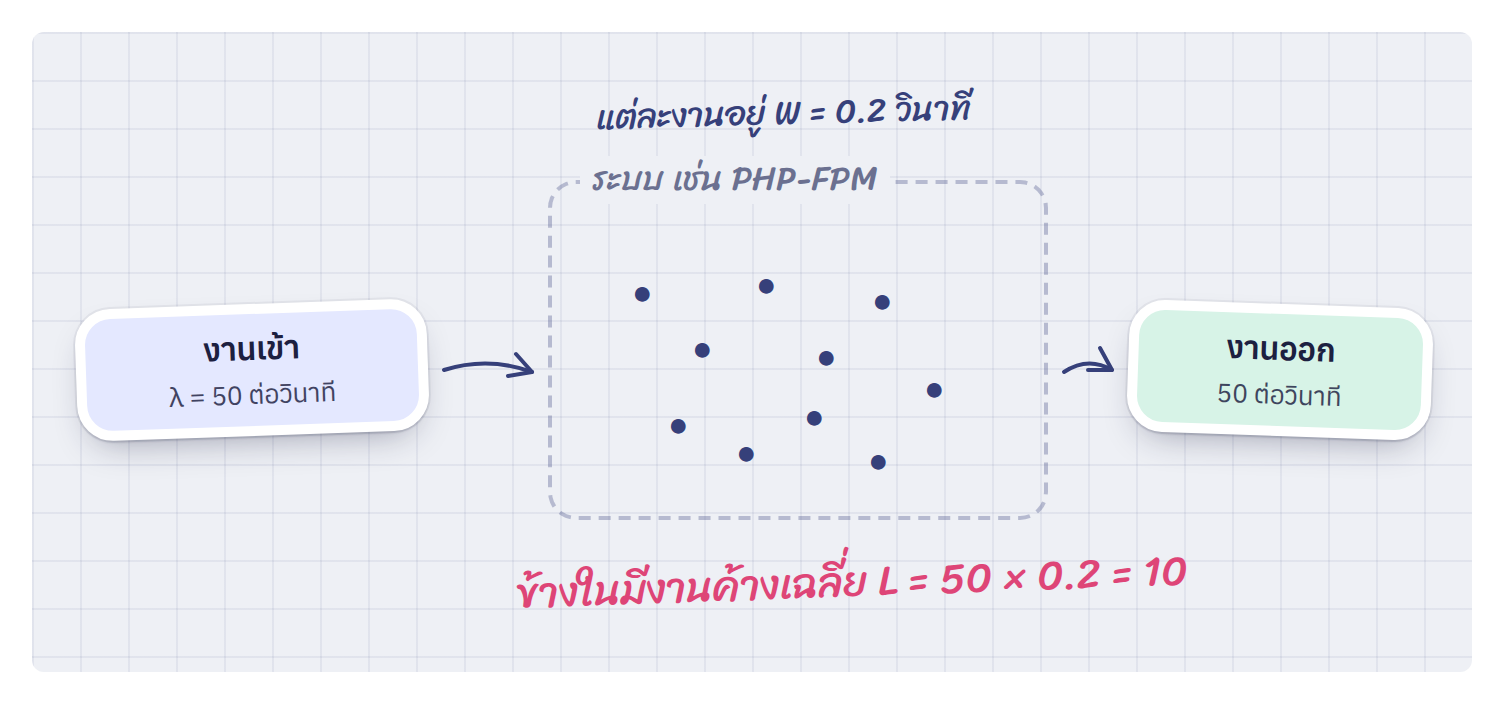
request เข้า 50 ต่อวินาที อยู่คนละ 0.2 วินาที ในระบบจึงมี request ค้างเฉลี่ย 10 ตัว
สูตรใช้ได้กว้างเพราะไม่สนรายละเอียดข้างใน
ข้อดีของ Little's Law คือไม่ต้องรู้ว่าข้างในระบบทำงานยังไง
- งานจะเข้ามาสม่ำเสมอหรือเป็นช่วง ๆ ก็ได้
- แต่ละงานจะใช้เวลาเท่ากันหรือต่างกันมากก็ได้
- ใครเข้าก่อนได้ทำก่อน หรือแซงคิวกันก็ได้
เงื่อนไขที่สำคัญมีข้อเดียว คือระบบต้องนิ่ง ในระยะยาวงานที่ออกต้องเท่ากับงานที่เข้า ถ้างานเข้าเร็วกว่าที่ระบบทำทัน คิวจะยาวขึ้นเรื่อย ๆ ไม่มีค่าเฉลี่ยให้คำนวณ ซึ่งก็เป็นสัญญาณว่าระบบรับไม่ไหวแล้ว
อีกข้อที่ใช้บ่อยคือ ใช้กับส่วนย่อยของระบบได้ จะนับทั้งเว็บ นับแค่คิวที่รอ หรือนับแค่ worker ที่กำลังทำงานก็ได้ ขอแค่ L, λ และ W นับจากขอบเขตเดียวกัน
ประมาณจำนวน worker ของ PHP-FPM
PHP-FPM ให้ worker หนึ่งตัวทำ request ทีละหนึ่งตัว และจำกัดจำนวน worker ด้วย pm.max_children ถ้า worker ไม่ว่างครบทุกตัว request ใหม่ก็ต้องรอ
สมมติเว็บมี 50 request ต่อวินาที แต่ละ request ใช้เวลาเฉลี่ย 0.2 วินาที
worker ที่ไม่ว่าง = 50 × 0.2 = 10 ตัวถ้าตั้ง pm.max_children ไว้ 20 ก็ยังมีที่ว่างเหลือ ทีนี้ถ้ามีหน้าหนึ่งที่ได้ 10 request ต่อวินาที ต้องรอ API ภายนอกที่ช้าลงเป็น 3 วินาที ลองแยกคิดทีละส่วน เพราะสูตรใช้กับส่วนย่อยได้
หน้าอื่น       40 × 0.2 = 8 ตัว
หน้าที่รอ API  10 × 3   = 30 ตัว
รวม                      38 ตัว
ต้องใช้ 38 ตัวแต่มีแค่ 20 request ที่เหลือจึงต่อคิว หน้าอื่นที่ไม่ได้เรียก API ตัวนั้นก็ช้าตามไปด้วย เพราะต้องรอ worker ว่าง ทั้งที่คนใช้เท่าเดิม ระหว่างนั้น CPU ของเครื่องยังต่ำ เพราะ worker ส่วนใหญ่แค่นั่งรอ network
เรื่องนี้เป็นจุดตั้งต้นของโพสต์ retry ตอนบริการปลายทางช้าทำให้ระบบล่มหนักกว่าเดิมได้ ที่เล่าต่อว่าตั้ง timeout, deadline และจำกัดงานที่ยิงพร้อมกันยังไง ถ้าสนใจลองอ่านต่อที่นั่นได้ครับ
ประมาณจำนวน queue worker และเวลาที่งานต้องรอ
queue worker หนึ่งตัวทำ job ได้ทีละตัว ถ้า job ใช้เวลาเฉลี่ย 2 วินาที worker หนึ่งตัวก็ทำได้ 0.5 job ต่อวินาที ถ้ามี job เข้ามา 5 ตัวต่อวินาที
worker ที่ไม่ว่าง = 5 × 2 = 10 ตัวถ้ามี worker แค่ 8 ตัว ระบบทำได้แค่ 4 job ต่อวินาที น้อยกว่าที่เข้ามา คิวจะยาวขึ้นเรื่อย ๆ จนกว่าช่วงที่ job เข้าเยอะจะผ่านไป
สูตรนี้ยังกลับด้านได้ คือ W = L / λ ถ้าเห็นว่ามี job รอในคิว 600 ตัว และ worker 10 ตัวทำได้ 5 job ต่อวินาที job ที่เพิ่งเข้าคิวจะรอราว 600 / 5 = 120 วินาที ตัวเลข wait time บนหน้า Horizon ก็คิดแนวเดียวกัน WaitTimeCalculator เอาจำนวน job ที่รอ คูณเวลาเฉลี่ยของ job ในคิวนั้น แล้วหารด้วยจำนวน process ที่ทำคิวนั้นอยู่
ประมาณจำนวน connection ของฐานข้อมูล
connection ของฐานข้อมูลก็นับแบบเดียวกัน ถ้ามี query 200 ครั้งต่อวินาที แต่ละ query ใช้ 25 ms
connection ที่ใช้อยู่ = 200 × 0.025 = 5 connectionแต่ถ้ามีรายงานตัวหนึ่งที่ถูกเรียก 5 ครั้งต่อวินาที และ query ช้าลงเป็น 2 วินาที ก็ต้องใช้เพิ่มอีก 5 × 2 = 10 connection เกือบสามเท่าของงานปกติทั้งหมด ทั้งที่เป็นแค่หน้าเดียว ใน PHP-FPM worker แต่ละตัวมักถือ connection ของตัวเองไว้ ถ้ามีหลายเครื่อง ตัวเลขนี้ก็ต้องคูณจำนวนเครื่องด้วย แล้วเทียบกับ max_connections ของ PostgreSQL ที่ค่าเริ่มต้นมักอยู่ที่ 100
สูตรบอกค่าเฉลี่ย ช่วงพีคจึงต้องเผื่อไว้
Little's Law ให้ค่าเฉลี่ย ไม่ได้บอกว่าในวินาทีที่แย่ที่สุดจะมีงานค้างเท่าไร เวลาใช้คำนวณจริงจึงควรใช้ตัวเลขจากช่วงที่หนักที่สุด
- λ ใช้ request ต่อวินาทีของชั่วโมงที่คนเข้าเยอะที่สุด ไม่ใช่ค่าเฉลี่ยทั้งวัน
- W ใช้เวลาตอนระบบช้า ไม่ใช่ตอนปกติ ถ้ามี API ภายนอก ให้คิดตอนที่ API ช้าด้วย
- ผลที่ได้ยังต้องเผื่อที่ว่างไว้ ระบบที่ใช้ worker ใกล้เต็มตลอดเวลา แค่งานเข้าเพิ่มนิดเดียวคิวก็ยาวขึ้นเร็วมาก
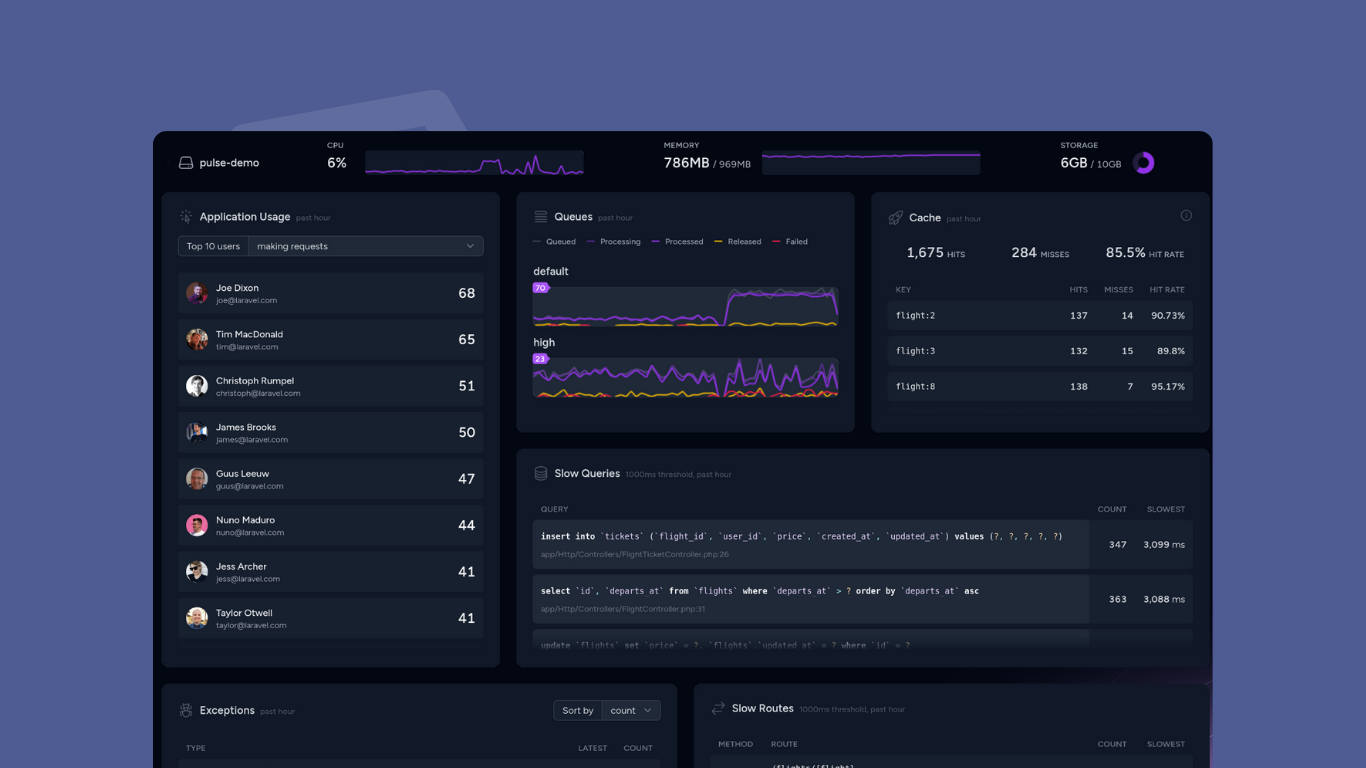
ตัวเลข λ และ W หาได้จาก log หรือ dashboard ที่มีอยู่ เช่น Laravel Pulse ที่แสดง request และ job ที่ช้า หรือหน้า Horizon ที่มี throughput และ runtime ของแต่ละคิว
rate limit กับ concurrency limit คุมคนละตัวในสูตร
พอมองผ่าน L = λW จะเห็นว่าเครื่องมือที่เราใช้กันงานล้นคุมคนละตัวในสูตร
- rate limit อย่าง middleware
throttleคุม λ คือจำนวนงานต่อวินาที - concurrency limit อย่าง
Redis::funnel()หรือจำนวน worker คุม L คือจำนวนงานที่ค้างพร้อมกันโดยตรง
ตอนปลายทางช้า λ ยังเท่าเดิม แต่ W โตขึ้นหลายเท่า L ก็โตตาม rate limit จึงกันไม่ได้ ต้องใช้ concurrency limit ส่วนการเพิ่ม worker เป็นการเพิ่มเพดานของ L ถ้าปลายทางไม่ได้เร็วขึ้น ก็แค่ส่งงานไปกองที่ปลายทางมากขึ้น