บริการปลายทางช้าลงนิดเดียว แอปเราก็ค้างได้ทั้งแอป
ต้นฉบับยกตัวอย่างหน้า checkout ที่ต้องถามค่าส่งจาก API ของขนส่ง ปกติ API ตอบใน 100 ms วันหนึ่งช้าลงเป็น 2 วินาที คำตอบยังถูกต้องทุกอย่าง แค่ช้า
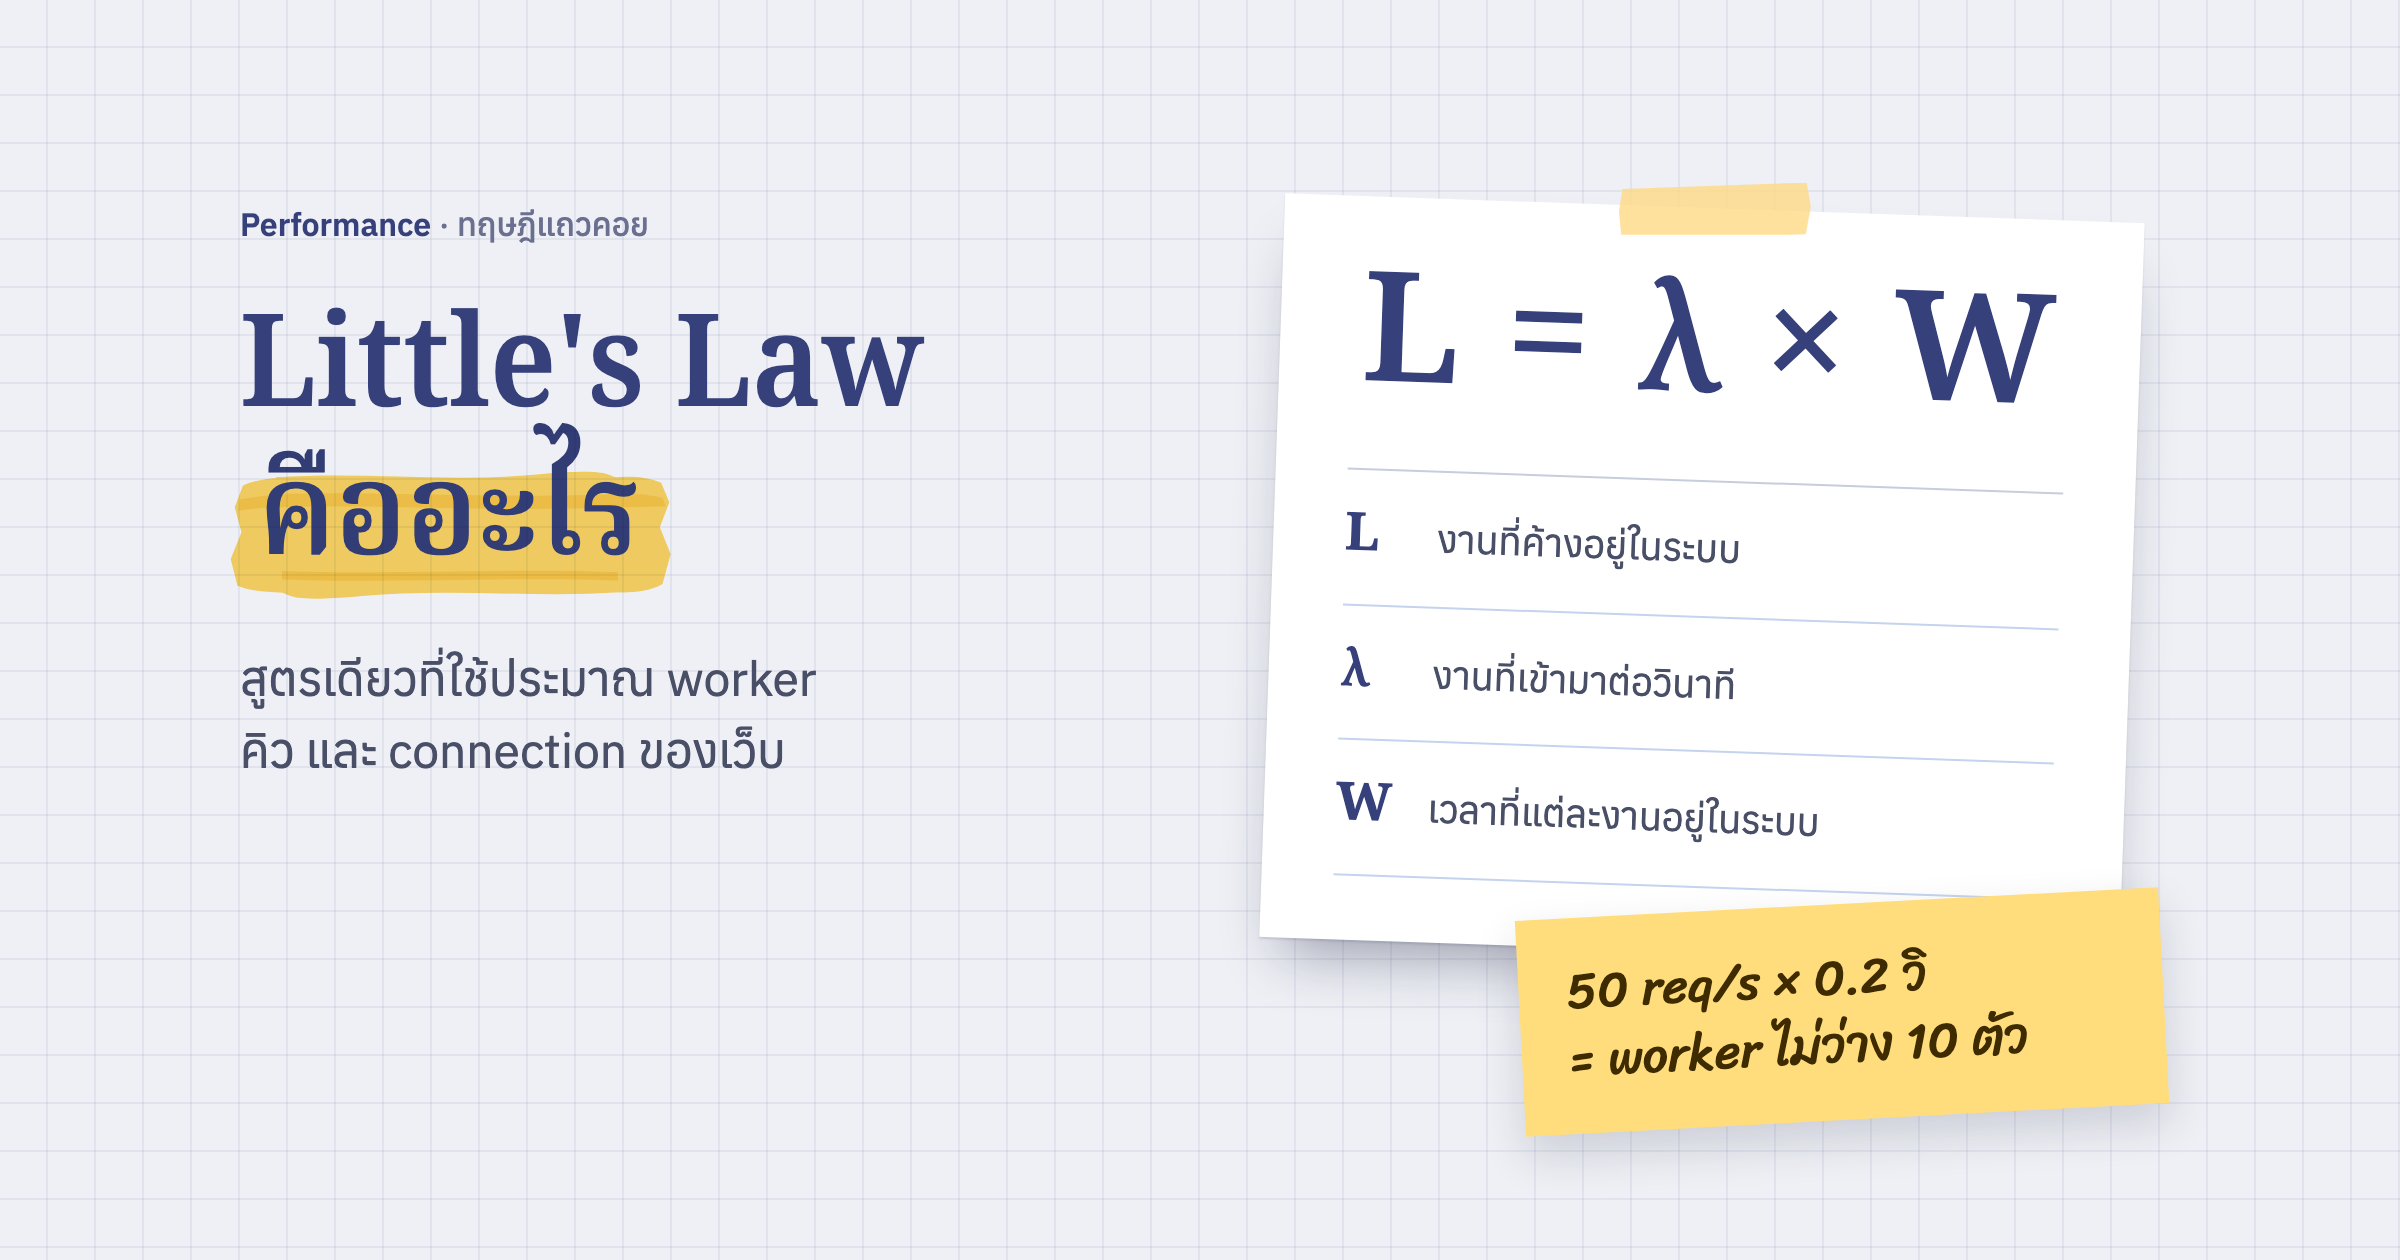
ทีนี้ลองคิดตามด้วยสูตรง่าย ๆ ที่เรียกว่า Little's Law คือ จำนวนงานที่ค้างพร้อมกัน = จำนวน request ต่อวินาที × เวลาที่แต่ละ request ใช้
| request ต่อวินาที | เวลาตอบ | ค้างพร้อมกัน | |
|---|---|---|---|
| ปกติ | 100 | 0.1 วินาที | ราว 10 |
| ปลายทางช้า | 100 | 2 วินาที | ราว 200 |
ในโลก PHP ตัวเลขนี้คือจำนวน worker ของ PHP-FPM ที่ยืนรอคำตอบอยู่ ถ้าเราตั้ง pm.max_children ไว้ 50 แอปจะรับได้แค่ 50 request พร้อมกัน ที่เหลือต่อคิวรอ หน้าอื่นที่ไม่เกี่ยวกับค่าส่งเลยก็ช้าตามไปด้วย เพราะไม่มี worker ว่าง
ที่น่ากลัวคือ CPU ของ server ยังต่ำอยู่ เพราะ worker แค่นั่งรอ network ถ้าดูแต่กราฟ CPU จะไม่เห็นว่ามีปัญหา และถ้าแก้ด้วยการเพิ่ม worker ก็แค่ส่ง request ไปกองที่ปลายทางมากขึ้น ให้ดูสามที่นี้แทน คือ slowlog ของ php-fpm ว่า stack trace จบที่ curl_exec บ่อยแค่ไหน log ของ php-fpm ที่ขึ้น seems busy หรือ 0 idle และ card Slow Outgoing Requests ของ Laravel Pulse ที่บอกว่า URL ไหนช้าบ่อย
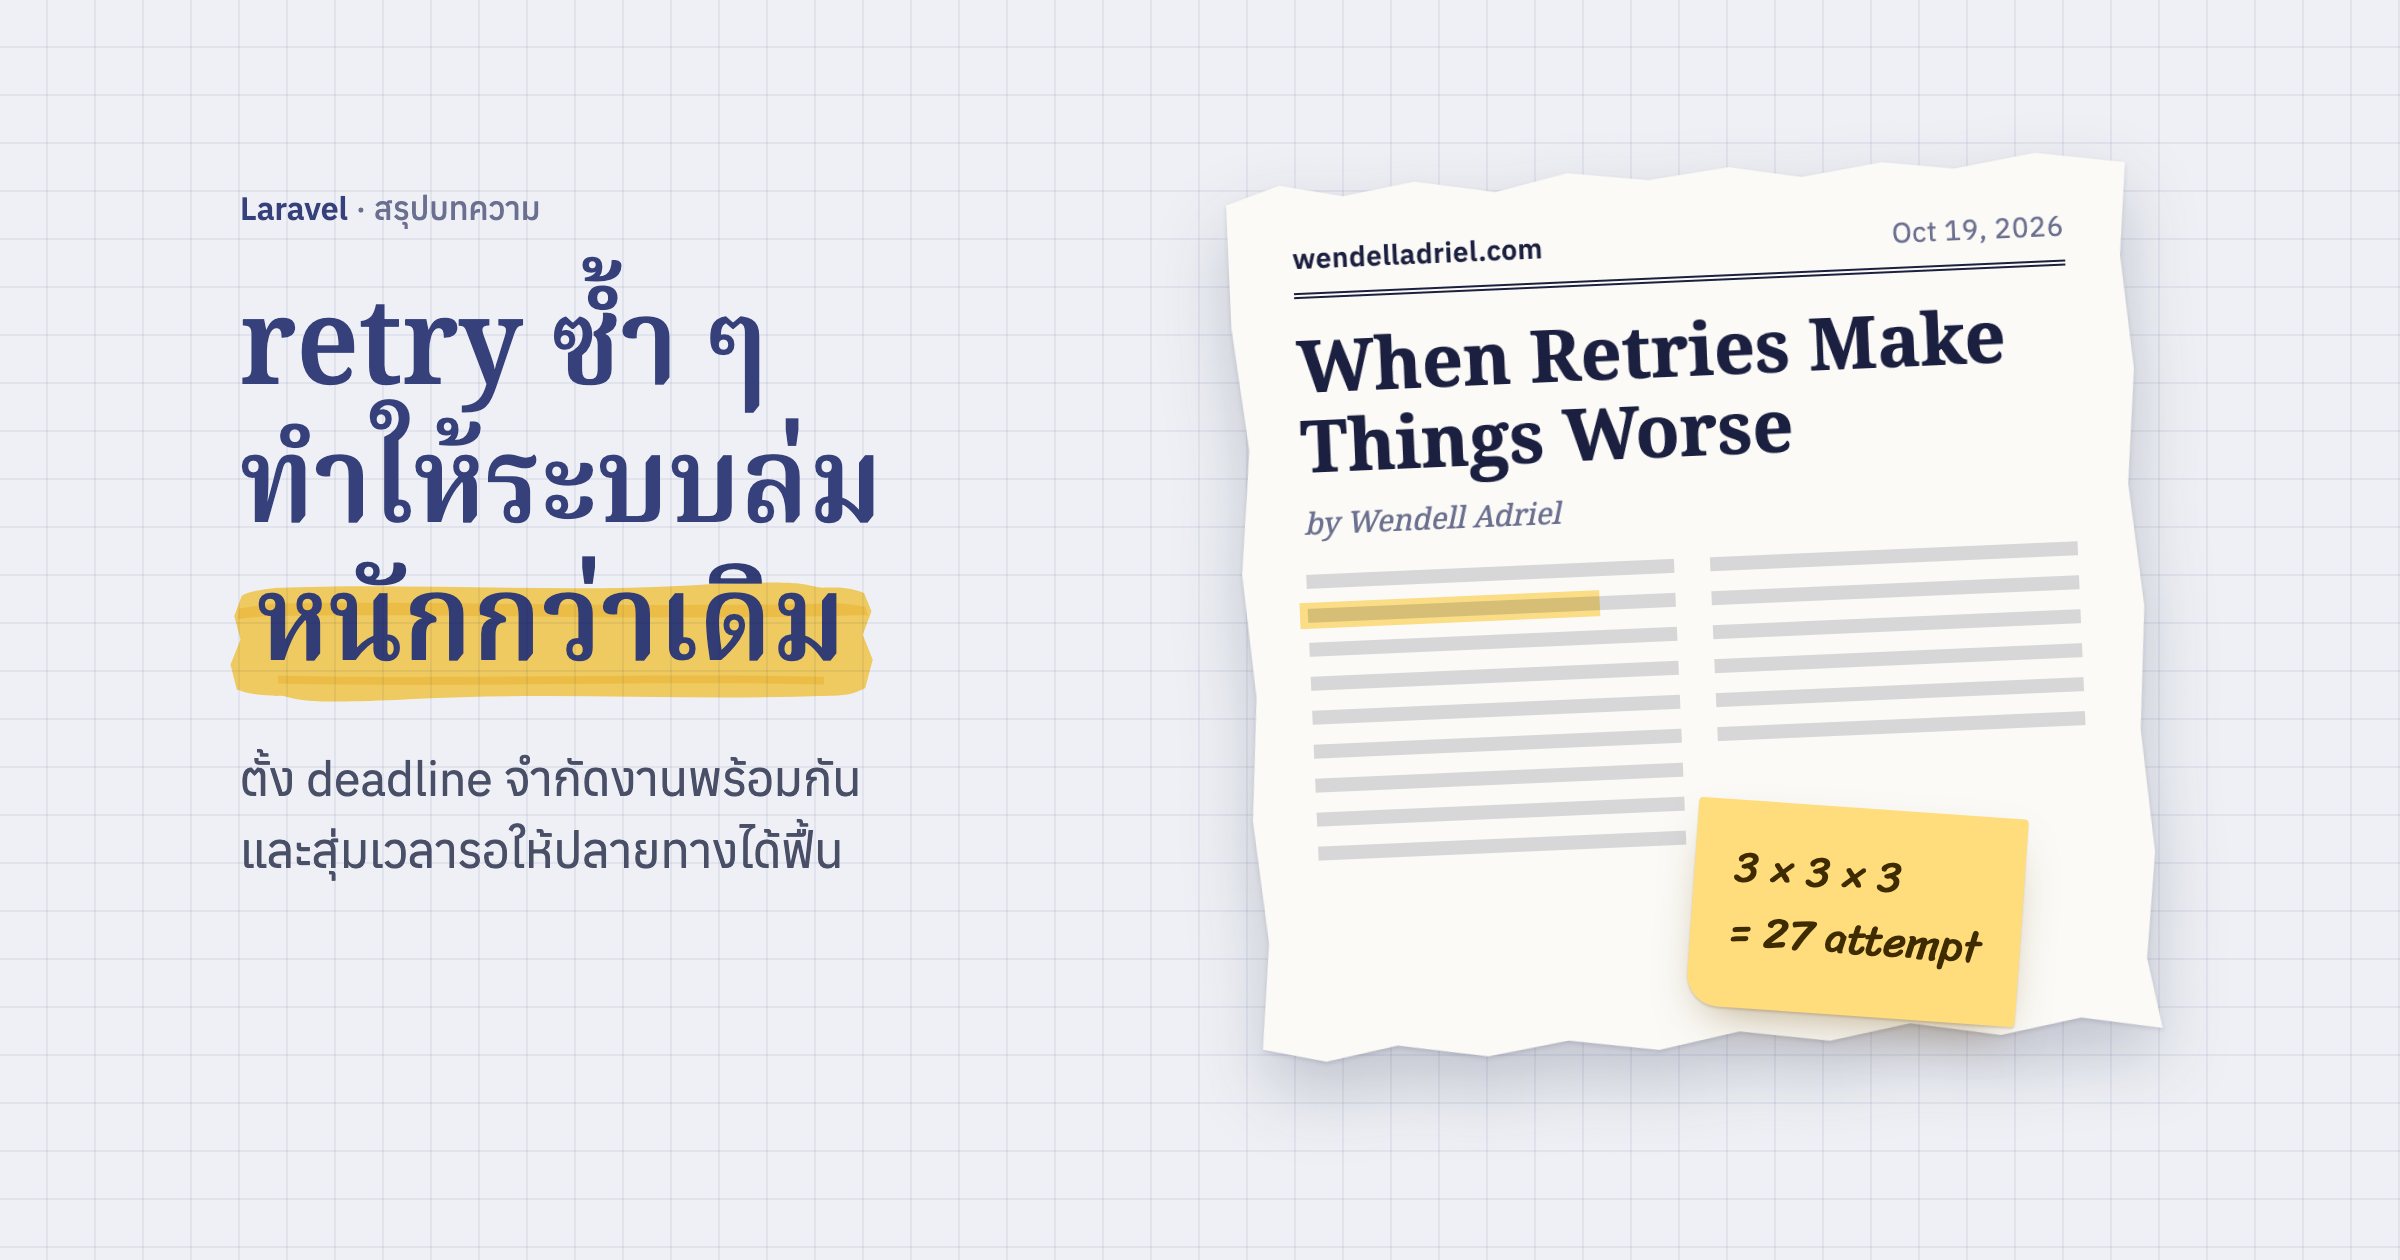
retry ซ้อนกันหลายชั้นคูณจำนวน request ขึ้นไปเรื่อย ๆ
ต้นฉบับแยกสองคำนี้ให้ชัด
- original request คืองานหนึ่งชิ้นที่ผู้ใช้สั่ง เช่น กดดูค่าส่งหนึ่งครั้ง
- attempt คือการยิงจริงแต่ละครั้ง รวมครั้งแรกและทุกครั้งที่ retry
ถ้าทุกชั้นตั้ง retry ไว้ 3 ครั้งเหมือนกัน ผลจะคูณกัน เบราว์เซอร์ลองได้ 3 ครั้ง แอป Laravel ลองได้ 3 ครั้ง และ HTTP client ที่ยิงไปขนส่งลองได้อีก 3 ครั้ง การกดปุ่มครั้งเดียวจึงกลายเป็น 3 × 3 × 3 = 27 attempt ที่ขนส่งได้รับ
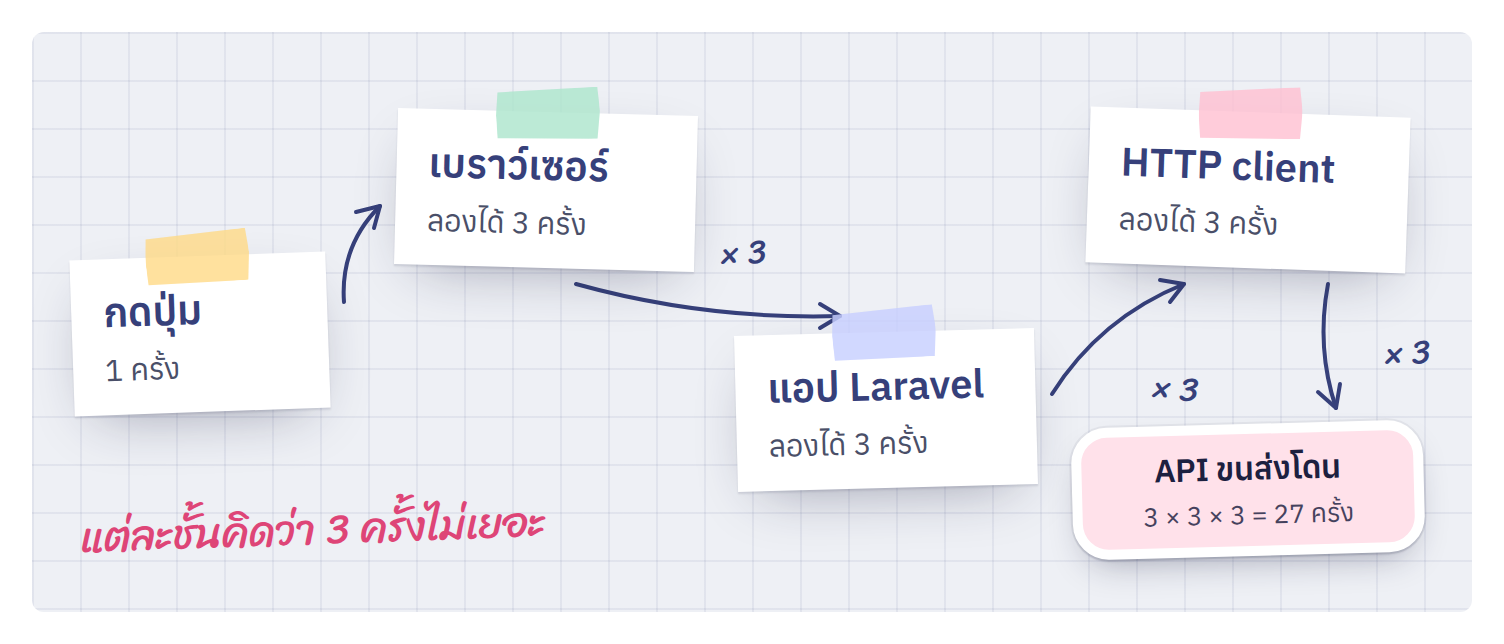
กดปุ่มครั้งเดียว ถ้าทุกชั้น retry 3 ครั้ง ปลายทางโดนได้ถึง 27 ครั้ง
ในแอป Laravel เรื่องนี้เกิดได้ง่ายกว่าที่คิด เช่น Http::retry(3) ที่อยู่ใน queue job ซึ่งตั้ง #[Tries(3)] ไว้ แค่นี้ก็ 9 attempt แล้ว ยังไม่นับผู้ใช้ที่กดปุ่มซ้ำเพราะหน้าค้าง
ต้นฉบับแนะนำให้ มีที่เดียวที่ตัดสินใจ retry คือ class ที่คุยกับ API ปลายทางโดยตรง ชั้นอื่นห้าม retry เอง เราจะได้นับได้ว่าจริง ๆ แล้วยิงไปกี่ครั้ง
ตั้ง deadline ให้ทั้งงาน แทนการตั้งแค่ timeout ต่อครั้ง
timeout จำกัดเวลารอของ attempt ครั้งเดียว ส่วน deadline จำกัดเวลาของงานทั้งก้อน ถ้าตั้ง timeout 500 ms กับ retry 3 ครั้ง งานนี้อาจใช้ 1.5 วินาทีไปกับการรออย่างเดียว ยังไม่นับเวลาพักระหว่างรอบ
ค่าเริ่มต้นของ HTTP client ใน Laravel ยิ่งนานกว่านั้น PendingRequest ตั้ง timeout ไว้ 30 วินาที และ connect_timeout 10 วินาที ถ้าไม่ตั้งเอง worker หนึ่งตัวรอได้นานถึงครึ่งนาทีต่อ attempt ให้ตั้งทั้ง connectTimeout() และ timeout() เสมอ
ต้นฉบับแบ่งงบเวลาแบบนี้ หน้า checkout มีเวลาทั้งหมด 900 ms กันไว้ 50 ms สำหรับจัดการคำตอบ ที่เหลือ 850 ms เป็นของการถามค่าส่ง รวมทุก attempt attempt แรกได้เวลาส่วนหนึ่ง attempt ที่สองได้แค่เวลาที่เหลือ ไม่ได้เริ่มนับ 850 ms ใหม่
ใช้ timeout คนละชุดระหว่างหน้าเว็บกับ queue
class ที่คุยกับ API ตัวเดียวกันถูกเรียกได้ทั้งจากหน้าเว็บและจาก queue job แต่สองที่นี้รอได้ไม่เท่ากัน หน้าเว็บมีคนรออยู่และจอง worker ของ php-fpm ไว้ ส่วน queue job รอได้นานกว่า ให้ class นั้นเลือกเพดานเองจากที่ที่โค้ดกำลังรันอยู่ เช่น
| เรียกจาก | ต่อ connection | รอคำตอบ | retry |
|---|---|---|---|
| หน้าเว็บ | ไม่เกิน 3 วินาที | ไม่เกิน 10 วินาที | ไม่มี |
| queue worker, scheduler, artisan | ค่าเต็มของ class | ค่าเต็มของ class | ตามนโยบาย |
Laravel บอกได้ว่ากำลังรันจากที่ไหนด้วย app()->runningInConsole() ซึ่งเป็นจริงในทั้งสามที่ของแถวล่าง ส่วน job ที่ dispatch_sync จากหน้าเว็บก็ได้เพดานของหน้าเว็บไปด้วย ซึ่งถูกแล้ว เพราะยังจอง worker ของ php-fpm อยู่
deadline เดียวครอบทุก call ใน job
งานจริงหนึ่งงานมักเรียกปลายทางหลายครั้ง อย่างการ query ระบบ ERP ผ่าน gateway หนึ่งครั้ง อาจมีทั้ง login ขอ token, ลงทะเบียน query, ยิง query จริง และถ้าเจอ 401 ก็ login ใหม่แล้วยิงซ้ำ ถ้าแต่ละ call มี timeout ของตัวเอง เวลารวมจะยาวเท่าผลบวกของทุก call
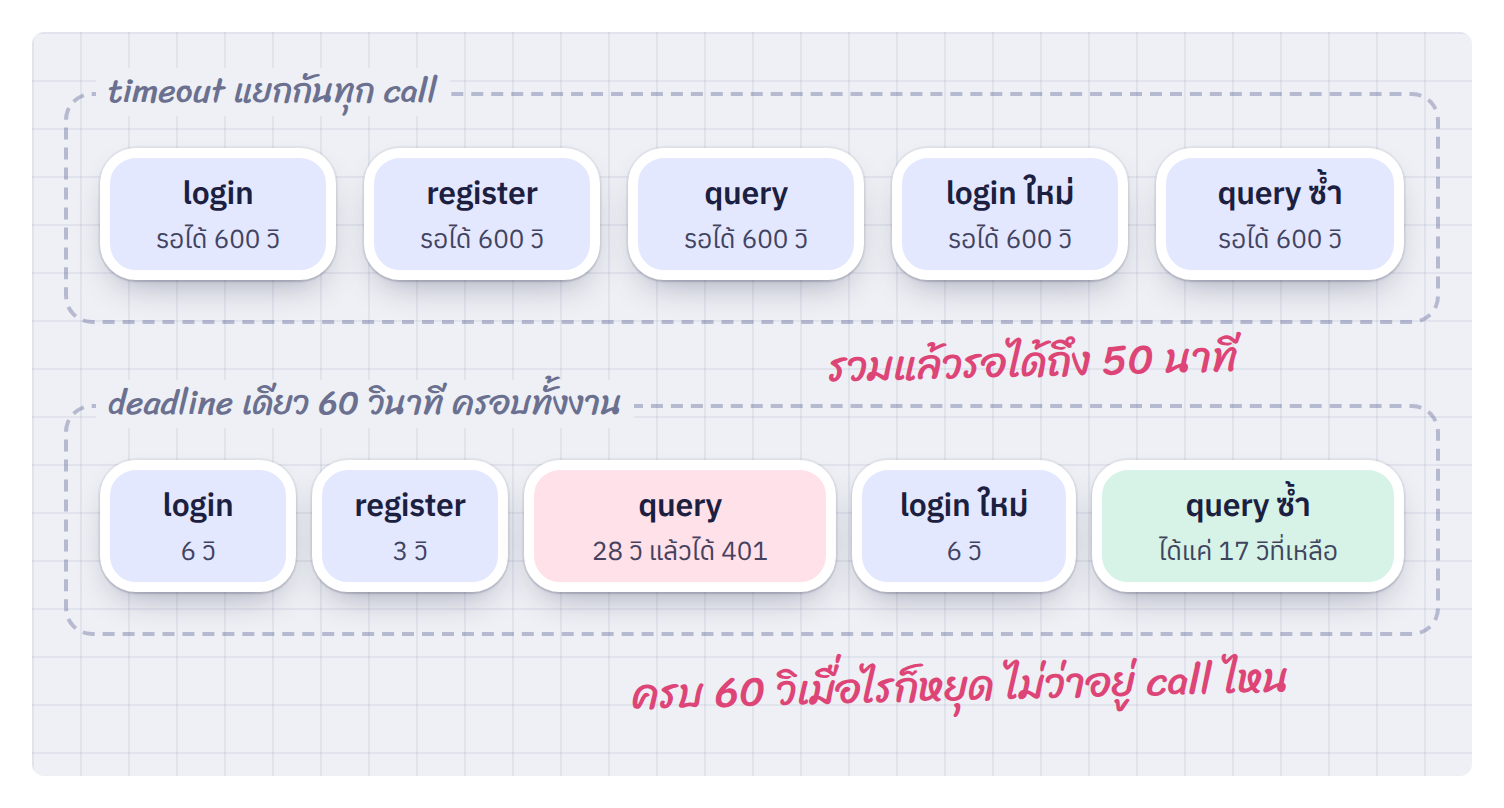
แถวบนแต่ละ call มี timeout ของตัวเอง แถวล่างทุก call ใช้เวลาจากก้อนเดียวกัน call สุดท้ายได้แค่เวลาที่เหลือ
ทางที่ดีกว่าคือเก็บเวลาสิ้นสุดของงานไว้ใน container ตอนเริ่ม job แล้วให้ทุก call ที่ยิงไปปลายทางใช้ timeout ที่น้อยกว่าระหว่างค่าของตัวเองกับเวลาที่เหลือ ถ้า deadline ซ้อนกันก็ใช้ตัวที่หมดก่อน ที่เก็บไว้ใน container แทน Context เพราะ Context ติดไปกับ job ที่ dispatch ต่อด้วย
timeout ทุกชั้นใน queue ต้องซ้อนกันพอดี
ใน queue มี timeout สามชั้น และต้องเรียงแบบนี้เสมอ
เวลารวมของ HTTP ใน job < $timeout ของ job < retry_after ของ queue connectionถ้า HTTP ใช้เวลาเกิน $timeout worker จะ kill job กลางทาง ก่อนได้เขียนผลลงฐานข้อมูล ถ้า $timeout เกิน retry_after queue จะเข้าใจว่า job หายไปแล้ว แล้วส่งให้ worker อีกตัวทำซ้ำทั้งที่ตัวแรกยังทำอยู่
--timeout ของ worker (หรือ timeout ใน supervisor ของ Horizon) เป็นแค่ค่าเริ่มต้นให้ job ที่ไม่ได้ตั้งเอง Worker::timeoutForJob() ใช้ $timeout ของ job ก่อนเสมอ job ที่ตั้ง $timeout = 600 จึงรันได้ครบ 600 วินาทีแม้ worker ตั้งไว้ 300 เพดานจริงมีแค่ retry_after
จำกัดจำนวนงานที่ยิงไปพร้อมกัน
สองคำนี้ฟังคล้ายกันแต่กันคนละเรื่อง
- rate limit จำกัดจำนวนครั้งต่อช่วงเวลา เช่น 100 ครั้งต่อวินาที
- concurrency limit จำกัดจำนวนงานที่ค้างอยู่พร้อมกัน เช่น ไม่เกิน 10 ตัว
ตอนปลายทางช้า rate เท่าเดิมแต่งานค้างพร้อมกันเพิ่มขึ้น 20 เท่า rate limit จึงกันไม่ได้ ต้องใช้ concurrency limit ต้นฉบับแนะนำให้เช็กก่อนยิงว่ายังมีช่องว่างไหม ถ้าไม่มีให้ตอบกลับทันทีด้วยผลที่เตรียมไว้ ไม่ต้องต่อคิวรอ
ใน Laravel ถ้ามี Redis ใช้ Redis::funnel() ได้เลย ตั้ง block(0) ให้ลองครั้งเดียวแล้วไปทางสำรองทันทีถ้าเต็ม
Redis::funnel('shipping-quote')
    ->limit(10)
    ->block(0)
    ->then(
        fn () => $this->callProvider($postcode),
        fn () => throw new ShippingQuoteUnavailable('คิวเรียกขนส่งเต็ม'),
    );
ชื่อ shipping-quote แยกช่องของ API แต่ละเจ้า ต้นฉบับเรียกวิธีนี้ว่า bulkhead คือกั้นห้องไว้ ถ้า API ค่าส่งช้า ก็ไม่ไปแย่งช่องของ API ข้อมูลสินค้า และเพราะ funnel เก็บสถานะไว้ใน Redis เพดาน 10 จึงเป็นของทั้งระบบ ถ้านับในหน่วยความจำของแต่ละเครื่อง server 4 เครื่องก็จะกลายเป็น 40
queue worker ก็คูณแบบเดียวกัน job ที่ยิงพร้อมกันได้ไม่เกิน 5 request บน worker 10 ตัว รวมแล้วยิงเข้าปลายทางได้ถึง 50 connection จึงควรนับช่องรวมทั้งระบบบน Redis เช่น 15 ช่อง กันไว้ 3 ช่องให้งานที่มีคนรอ นับเวลารอช่องรวมใน deadline และให้ช่องหมดอายุเองถ้า worker ตายกลางทาง
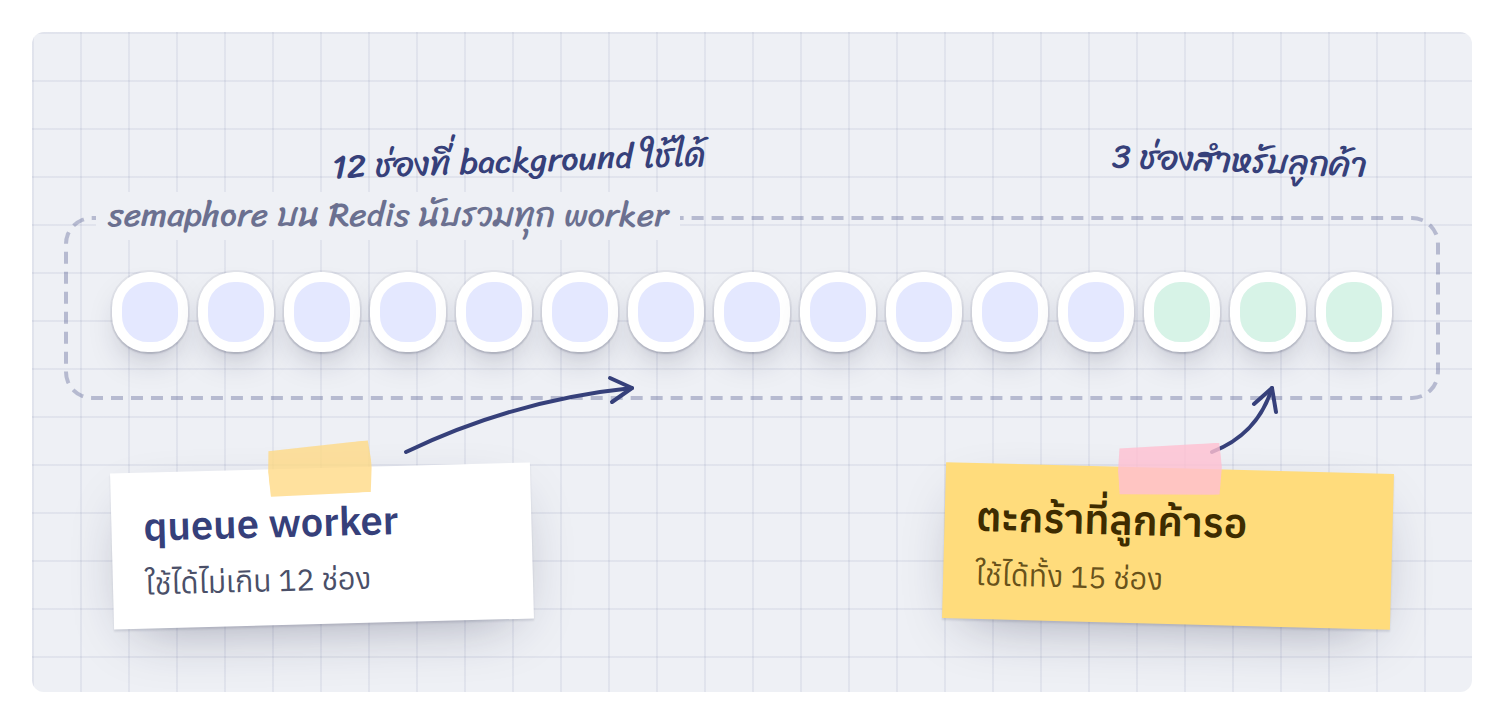
worker ทุกตัวขอช่องจากที่เดียวกัน งาน background ไม่มีวันใช้ 3 ช่องสุดท้าย
ส่วน job ที่ยิงหลาย request พร้อมกัน ถ้าแบ่งเป็น chunk แล้วรอให้ทั้ง chunk เสร็จก่อนค่อยยิง chunk ถัดไป request ที่ค้างตัวเดียวจะทำให้ทั้ง chunk รอ ใน Laravel 13 Http::pool() รับ concurrency ได้ และทำงานแบบ sliding window คือตัวไหนเสร็จก็ปล่อยตัวถัดไปเข้ามาทันที
Http::pool(fn (Pool $pool) => array_map(
    fn (string $sku) => $pool->as($sku)->timeout(60)->post($url, ['sku' => $sku]),
    $skus,
), concurrency: 5);
อีกเรื่องที่ต้นฉบับเตือนไว้ คือฝั่งเรา timeout แล้วปลายทางอาจยังทำ request นั้นอยู่ ตัวเลขช่องว่างของเราจึงดูดีกว่าความจริงได้ retry จึงต้องมีเพดานเสมอ
มีโควตา retry รวมของทั้งระบบ
retry ไม่เกิน 3 ครั้งต่องานฟังดูปลอดภัย แต่ตอนปลายทางล่มจริง ทุกงานจะ retry ครบ 3 ครั้ง ปลายทางก็โดน request เพิ่มเป็นสามเท่าในจังหวะที่แย่ที่สุด
ต้นฉบับจึงใช้ retry budget คือโควตา retry ที่นับรวมทุก request ทุก original request เติมโควตาให้ 0.1 ครั้ง ทุก retry ใช้โควตา 1 ครั้ง ถ้ามีงานเข้ามา 100 ครั้งต่อวินาที ก็ retry ได้ไม่เกินราว 10 ครั้งต่อวินาที
บน PHP-FPM ทุก request เริ่ม object ใหม่ ตัวนับจึงต้องอยู่ใน cache ที่ทุก worker เห็นร่วมกัน เช่นเก็บจำนวนงานกับจำนวน retry ของแต่ละนาทีไว้ใน Redis แล้วให้ retry ได้ 5 ครั้งเสมอ บวกอีก 10% ของงานในนาทีนั้น
| งานในนาทีนั้น | retry ได้ไม่เกิน |
|---|---|
| 10 | 6 |
| 100 | 15 |
| 1,000 | 105 |
ค่าตั้งต้น 5 ครั้งช่วยให้ช่วงที่คนใช้น้อย ๆ ยัง retry ได้บ้าง ส่วน job ที่ยิงทีละหลายสิบรายการ ใช้นโยบายเดียวกันแบบง่ายกว่านั้นได้ คือดูสัดส่วนก่อน ถ้าล้มไม่กี่ตัวก็ retry ตัวที่ล้ม ถ้าล้มเกินครึ่ง แปลว่าปลายทางมีปัญหาจริง ก็ข้ามรอบ retry ไปเลย
สุ่มเวลารอก่อน retry และคืนช่องก่อนพัก
backoff คือรอก่อนลองใหม่ ส่วน jitter คือสุ่มเวลารอนั้น ไม่ให้ทุกงานที่พังพร้อมกันกลับมายิงพร้อมกันอีกรอบ ต้นฉบับใช้แบบ full jitter คือสุ่มระหว่าง 0 ถึงเพดานที่โตขึ้นเรื่อย ๆ เริ่มที่ 25 ms คูณสองทุกรอบ แต่ไม่เกิน 200 ms
Http::retry() ของ Laravel รับ closure เป็นเวลารอได้ และรับ closure อีกตัวที่บอกว่าเคสไหนควร retry ในที่นี้ retry เฉพาะต่อไม่ติด กับ 429 และ 503
Http::connectTimeout(0.3)->timeout(0.3)->retry(
    2,
    fn (int $attempt) => random_int(0, min(200, 25 * 2 ** ($attempt - 1))),
    fn (Throwable $e) => $e instanceof ConnectionException
        || ($e instanceof RequestException && in_array($e->response->status(), [429, 503])),
)->get('https://api.shipping.example/quote', ['postcode' => $postcode]);
ส่วน queue job ที่ใช้ #[Backoff(60, 300)] แบบเลขตายตัว ถ้ามี job พังพร้อมกันเป็นร้อยตัว ทุกตัวจะกลับมาพร้อมกันอีกในอีก 60 วินาที ให้เขียนเป็น method backoff() ที่สุ่มค่าแทน Laravel อ่าน method นี้ตอน dispatch แต่ละ job จึงได้ชุดเวลาของตัวเอง
public function backoff(): array
{
    return [random_int(30, 90), random_int(240, 360)];
}
job ที่เรียก release() เองก็ต้องสุ่มเวลาที่ส่งให้ release() ด้วย วิธีนี้เหมาะกับปลายทางที่ค้างเป็นช่วง ๆ ซึ่ง timeout ที่ยาวขึ้นหรือ retry ทันทีก็ไม่ช่วย ให้ job กลับเข้าคิวไปรอราว 5 นาที แล้วราว 10 นาที โดยสุ่มเป็นช่วง
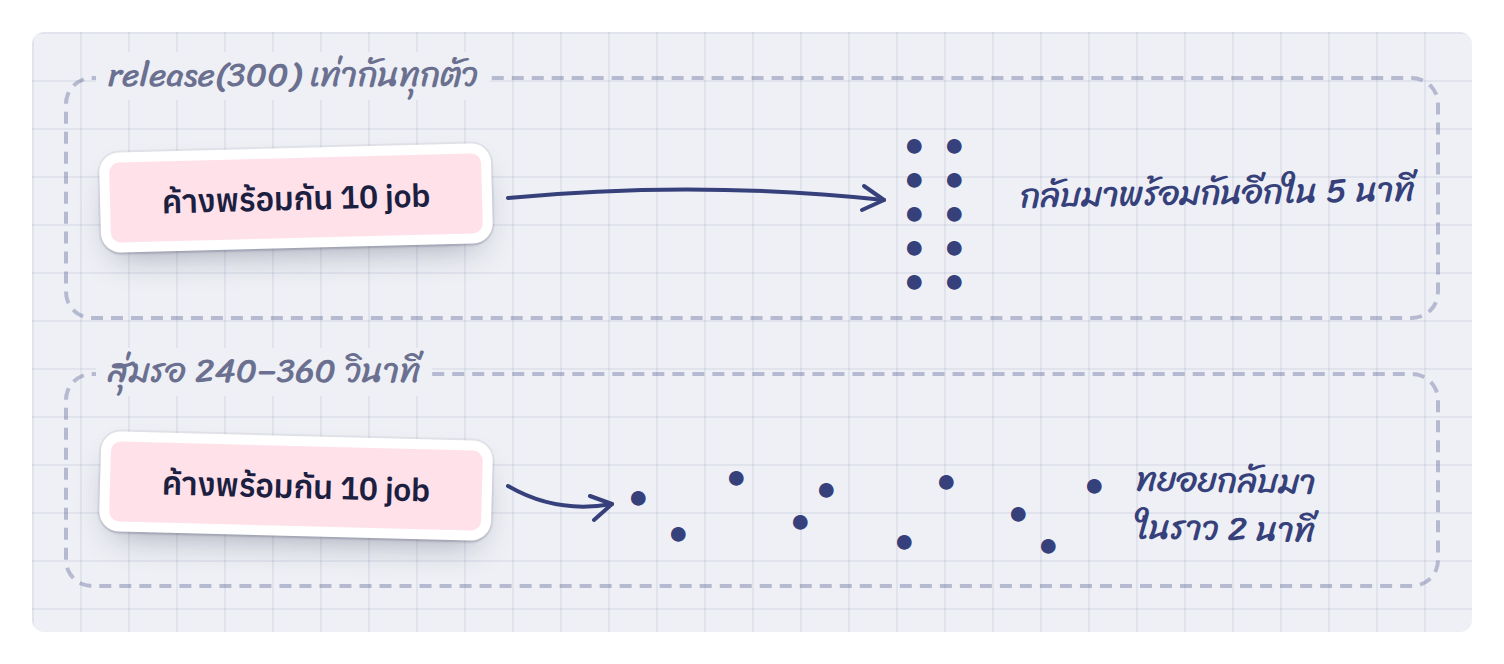
job ที่ค้างพร้อมกัน ถ้ารอเท่ากันก็กลับมาเป็นชุดเดิม ถ้าสุ่มช่วงก็ทยอยกลับมา
ถ้าปลายทางส่ง header Retry-After มาให้ ให้รอตามนั้น และถ้าเวลาใน deadline เหลือไม่พอให้รอ ก็หยุดเลย อย่าแอบลดเวลารอให้สั้นกว่าที่ปลายทางขอ
อีกจุดที่ต้นฉบับย้ำ คือคืนช่องใน concurrency limit ก่อนพัก ถ้าถือช่องไว้ระหว่างรอ งานอื่นก็ใช้ช่องนั้นไม่ได้ Http::retry() ที่อยู่ใน Redis::funnel() จึงยังไม่พอ เพราะ funnel ถือช่องไว้ตลอดการ retry ทุกรอบ ส่วน retry ในหน้าเว็บควรสั้นและมีเพดาน งานที่ต้องรอนานกว่านั้นให้ย้ายไปเป็น queue job
รวมทุกข้อไว้ใน class เดียวที่คุยกับขนส่ง
ต้นฉบับรวมทุกอย่างไว้ในฟังก์ชันเดียว ใน Laravel ทำเป็น class เดียวที่เป็นเจ้าของ retry ของ API นั้น ทุกหน้าและทุก job เรียกผ่าน class นี้ แต่ละรอบทำตามลำดับนี้
- ตั้ง deadline 850 ms ครั้งเดียวตอนเริ่ม ทุก attempt ใช้เวลาที่เหลือจากก้อนเดียวกัน
- ก่อน retry ขอโควตาจาก retry budget ถ้าหมดก็ตอบด้วยผลสำรอง
- ขอช่องจาก funnel แล้วยิงหนึ่ง attempt ได้ไม่เกิน 300 ms หรือเท่าที่เหลือ HTTP client ข้างในไม่มี
retry()ของตัวเอง - retry เฉพาะ error ชั่วคราว (ต่อไม่ติด, 429, 503) error อื่นโยนออกไปเลย
- คืนช่องทันทีที่ attempt จบ แล้วค่อยพักแบบสุ่มนอก funnel
- ถ้าเวลาที่เหลือไม่พอให้พักแล้วลองอีกรอบ ก็หยุดแล้วตอบด้วยผลสำรอง
ตัดสินใจไว้ก่อนว่าลูกค้าจะเห็นอะไรเมื่อระบบไม่รับงาน
ทุกข้อข้างบนทำให้บางงานจบด้วย "ไม่ทำ" ต้นฉบับเรียกการปฏิเสธงานส่วนเกินแบบนี้ว่า load shedding และบอกว่าต้องคุยกับฝ่ายธุรกิจไว้ก่อนว่าจะตอบลูกค้ายังไง อย่าไปคิดเอาตอนระบบล่ม ตัวอย่างทางเลือกของหน้า checkout
- แสดงค่าส่งโดยประมาณ และเขียนไว้ชัดว่าเป็นราคาประมาณ
- ใช้ค่าส่งที่เพิ่งถามได้ของพัสดุแบบเดียวกัน
- บอกให้ลองใหม่อีกครั้งในอีกสักครู่
- ห้ามแสดงค่าส่ง 0 บาท อันนี้คือบั๊ก
ระบบหลังบ้านที่ดึงสต็อกและวงเงินจาก ERP ก็ตัดสินใจไว้ทีละหน้าได้ เช่น หน้าเช็กสต็อกตอบด้วยยอดล่าสุดที่เก็บไว้ พร้อมบอกลูกค้าว่าเป็นยอดล่าสุดที่มี ไม่แสดงสต็อกเป็น 0 ส่วนการสร้างใบเสนอราคาไม่ retry เลย และย้ายไปทำใน queue เพราะการสร้างซ้ำจะได้ใบเสนอราคาสองใบ
ถ้าเราเป็นฝั่ง API ให้คนอื่นเรียก 503 หมายถึงตอนนี้ระบบรับไม่ไหว ส่วน 429 หมายถึงผู้เรียกรายนี้ยิงเกินโควตา ควรส่ง Retry-After ไปด้วยทั้งสองแบบ คนเรียกที่ดีจะลดจังหวะการยิงตามสัญญาณนี้ ต้นฉบับเรียกพฤติกรรมนี้ว่า backpressure
ส่วน circuit breaker ที่หยุดเรียกปลายทางไปพักหนึ่งหลังพังติดกันหลายครั้ง ต้นฉบับมองว่ามีประโยชน์ แต่เป็นสถานะอีกชุดที่ต้องดูแล ควรทำ deadline, concurrency limit และ retry budget ให้ได้ก่อน ใน queue job ของ Laravel มี middleware ThrottlesExceptions ที่ทำงานคล้าย circuit breaker อยู่แล้ว
ลองทำให้ปลายทางช้า แล้วดูว่าระบบฟื้นไหม
test ที่ให้ปลายทางพังหนึ่งครั้งแล้วรอบสองผ่าน บอกได้แค่ว่า retry ทำงาน ต้นฉบับจึงทดลองด้วย API ปลอมที่รับงานพร้อมกันได้ 4 ตัว ยิงงานเข้าไป 50 ครั้งต่อวินาที แล้วทำให้ปลายทางช้า จากนั้นทำให้กลับมาปกติโดยไม่หยุดยิง เทียบแบบที่ retry 3 ครั้งเฉย ๆ กับแบบที่มีเพดานครบ แล้วดูว่างานที่ค้างระบายออกได้ไหม
ตัวยิงโหลดต้องยิงตามอัตราที่ตั้งไว้ตลอด ไม่รอคำตอบก่อนแล้วค่อยยิงตัวถัดไป ไม่อย่างนั้นพอระบบช้าลง ตัวยิงก็ยิงช้าลงตาม ถ้าใช้ k6 ให้เลือก executor แบบ constant-arrival-rate
ค่าที่ควรเก็บไว้ดูตอนระบบมีปัญหา
นับ error อย่างเดียวไม่พอจะบอกว่า retry ช่วยหรือซ้ำเติม ต้นฉบับแนะนำให้เก็บแยกกันดังนี้
- จำนวน original request กับจำนวน attempt ที่ยิงจริง เอา attempt หาร original จะเห็นว่า retry คูณงานขึ้นกี่เท่า
- งานที่สำเร็จภายใน deadline
- retry ที่ยิงไป retry ที่ช่วยให้งานสำเร็จ และ retry ที่โควตาไม่ให้ยิง
- งานที่ค้างอยู่ตอนนี้ และงานที่ concurrency limit ปฏิเสธ
- เวลาตอบของปลายทาง แยกงานที่สำเร็จออกจากงานที่เราปฏิเสธไปเร็ว ๆ เพราะถ้ารวมกัน ค่าเฉลี่ยจะดูดีทั้งที่ปฏิเสธงานไปเยอะ
จะนับได้ทุกค่า ทุก call ที่ออกไปต้องผ่านจุดบันทึกจุดเดียว แล้วแยกการปฏิเสธของเราออกจาก error ของปลายทาง คนดูกราฟจะได้ไม่เข้าใจผิดว่าการป้องกันคือ error อีกตัว ถ้าอยากให้ทุกบรรทัดของ log มี request ID ลองดูวิธีใช้ Laravel Context ได้
กรณีที่อาจเจอเมื่อปลายทางช้าจริง
CPU ต่ำ แต่เว็บช้าทั้งเว็บ ระบบหลังบ้านตัวหนึ่งที่เราดูแลต่อกับ SAP ผ่าน gateway ช่วง peak log ของ php-fpm ขึ้น seems busy … 0 idle ทั้งที่ CPU ไม่สูง worker ทั้ง 20 ตัวของ pool ค้างอยู่ใน curl_exec รอ SAP ตอบ อาการแบบนี้แก้ด้วยเพดานเวลาของหน้าเว็บกับ concurrency limit รวมทั้งระบบ เพิ่ม worker ไปก็แค่มีตัวค้างรอเพิ่มขึ้น
timeout สั้นจนไม่ได้ข้อมูลเลย ระบบเดียวกันเคยตั้ง timeout ของ queue ไว้ 12 วินาที ช่วงที่ SAP ช้า call ที่ใช้เวลาราว 40 วินาทีจึง timeout ทุกรอบ ทั้งที่ 97.8% ของ call ตอบภายใน 60 วินาที พอขยายเป็น 60 วินาทีโดยมี deadline ของ job คุมอยู่ ก็ได้ข้อมูลกลับมา timeout สั้นจึงไม่ได้ดีกว่าเสมอ ให้ตั้งจากการกระจายของเวลาตอบใน log ช่วงที่ปลายทางช้า แล้วให้ concurrency limit กับ deadline คุมไม่ให้ worker ค้างนานเกิน
endpoint ค้างเป็นเวลา endpoint ดึงสต็อกตัวหนึ่งค้างพร้อมกันราว 10 call ในรอบดึงข้อมูลตอนเที่ยงแทบทุกวัน ขณะที่ endpoint อื่นบน host เดียวกันยังตอบปกติ และรอบถัดไปก็ตอบได้ตามเดิม แบบนี้ timeout ยาวขึ้นไม่ช่วย ที่ช่วยคือ release() กลับเข้าคิวด้วยเวลาที่สุ่มเป็นช่วงตามหัวข้อ jitter
ต้นฉบับปิดท้ายด้วยการชวนให้เลือก API ปลายทางสักตัวที่เรายังนับไม่ได้ว่ายิงไปจริงกี่ครั้ง แล้วลองทำให้ปลายทางตัวนั้นช้าดู ใครอยากอ่านตัวอย่าง PHP ฉบับเต็มและรายละเอียดการทดลอง ตามไปอ่านที่ บทความของ Wendell Adriel ได้ครับ