PHP ทำงานทีละบรรทัดจนกว่าเราจะแยก process
ลองนึกถึงหน้า dashboard ที่ต้องดึงยอดขาย จำนวนลูกค้า และสินค้าใกล้หมด สมมติว่าแต่ละ query ใช้เวลา 1 วินาที ปกติ PHP จะรันทีละตัว ผู้ใช้จึงรอ 3 วินาที ทั้งที่สามงานนี้ไม่ได้รอผลของกันเลย
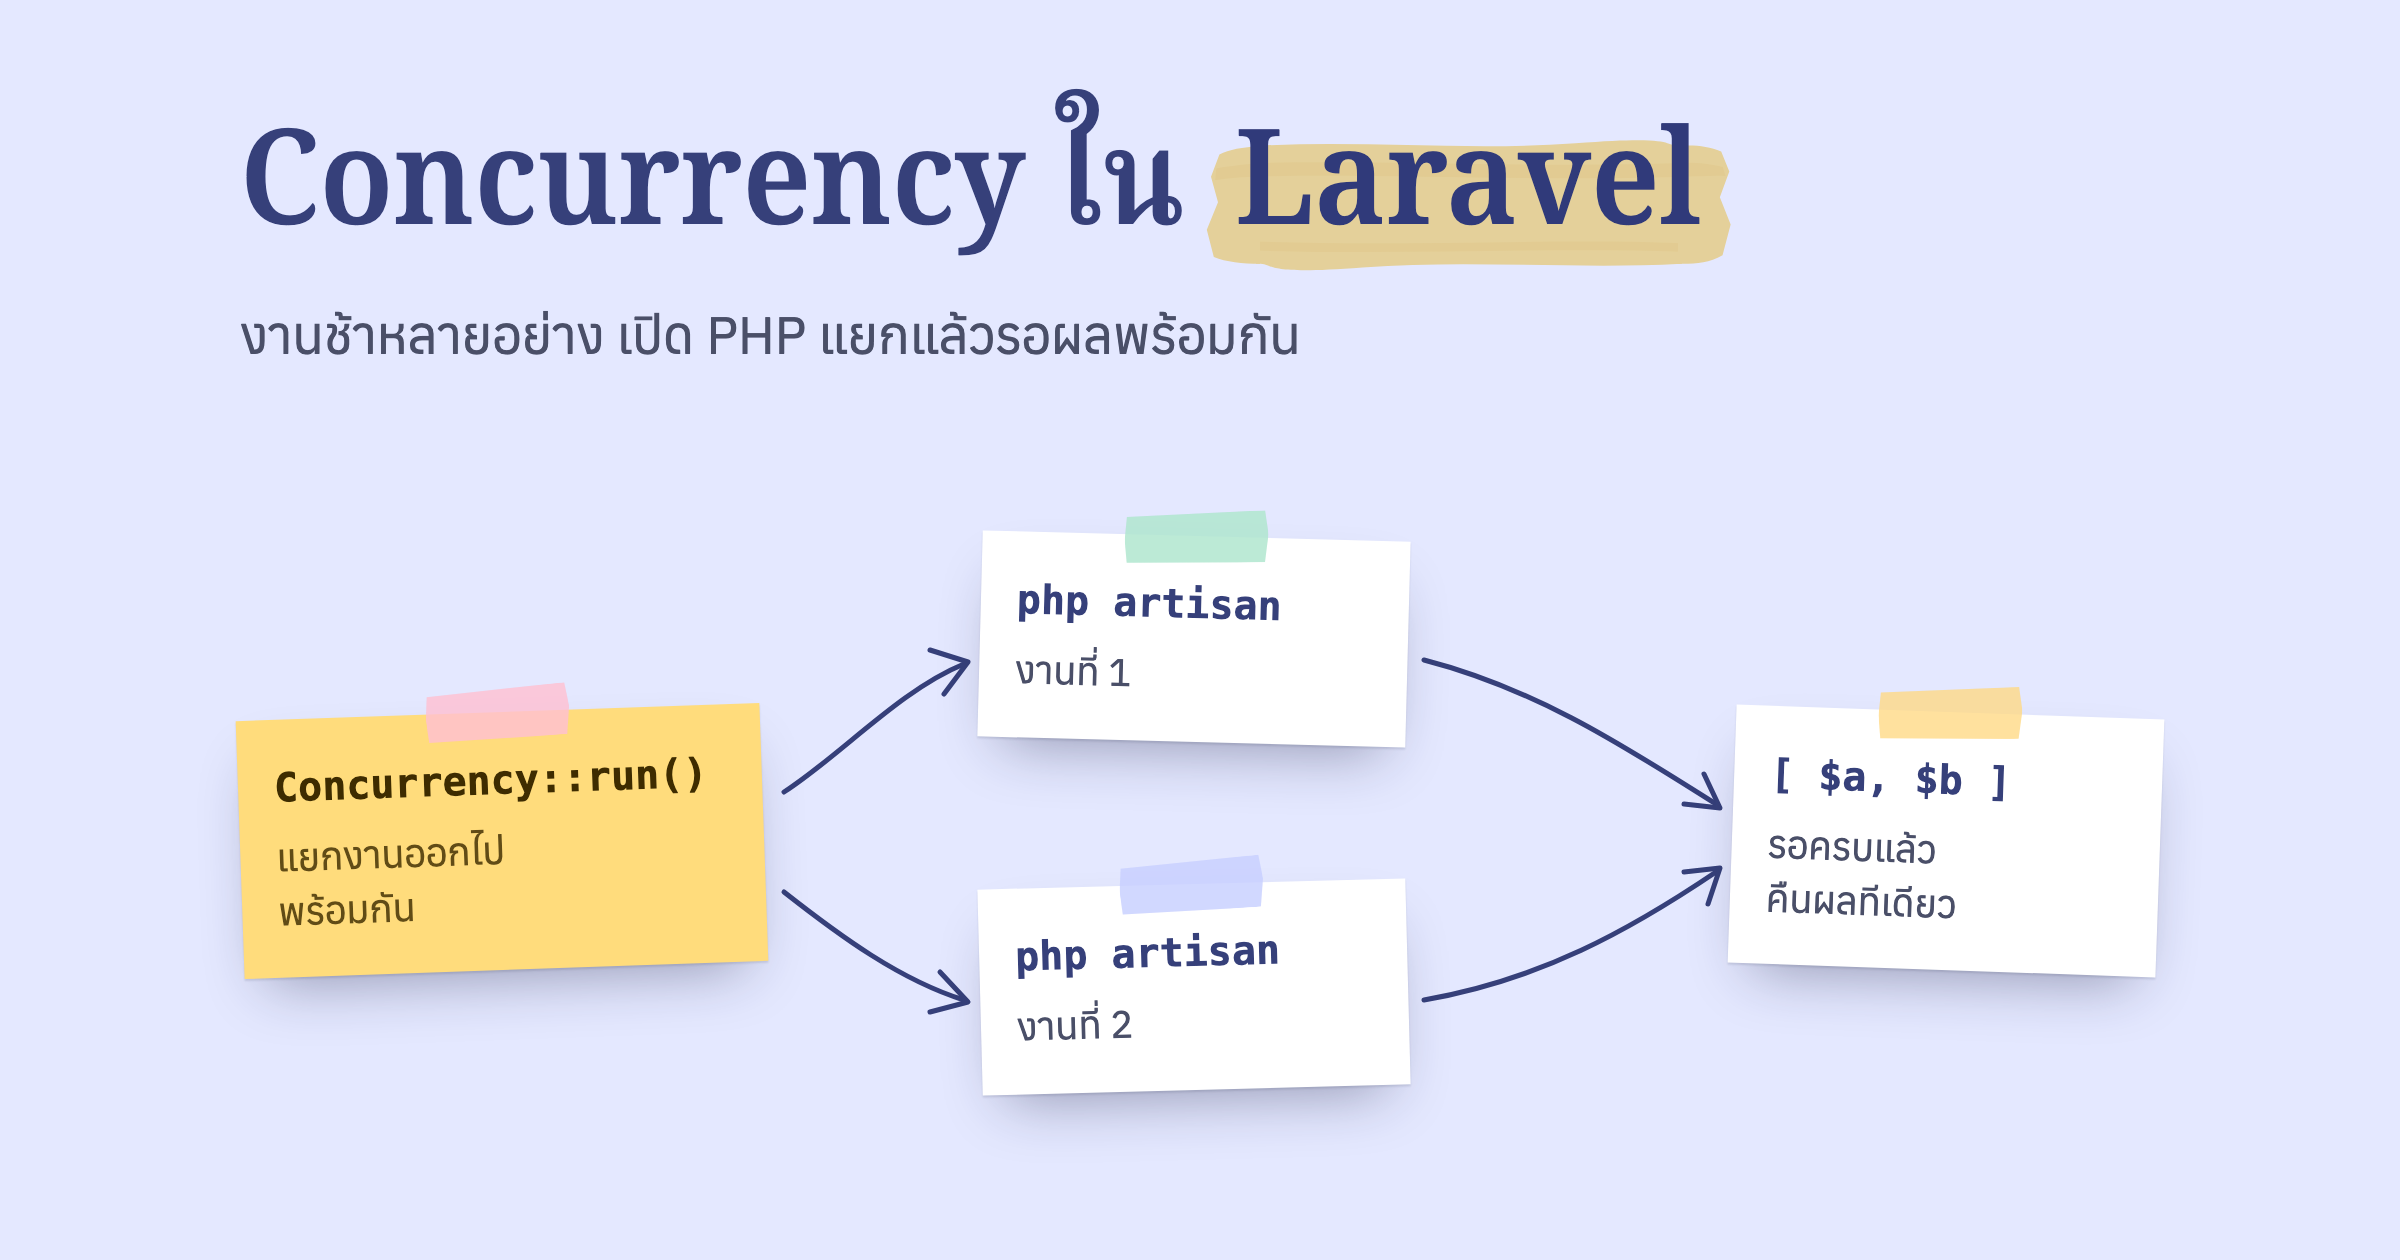
Concurrency::run() (เอกสาร) แยกงานเหล่านี้ออกไปรันพร้อมกัน แล้วคืนผลตามลำดับเดิม
use Illuminate\Support\Facades\Concurrency;
use Illuminate\Support\Facades\DB;

$results = Concurrency::run([
    'sales' => fn () => DB::table('orders')->sum('total'),
    'customers' => fn () => DB::table('customers')->count(),
    'lowStock' => fn () => DB::table('products')->where('stock', '<', 5)->count(),
]);

$results['sales'];
เวลาที่ใช้จะเท่ากับงานที่ช้าที่สุดบวกค่าเปิด process ตอนลองรันงาน sleep(1) สามงานบนเครื่องพัฒนา แบบทีละงานใช้ 3.02 วินาที ส่วน Concurrency::run() ใช้ 1.31 วินาที
Laravel เปิด PHP ใหม่หนึ่งตัวต่อหนึ่งงาน
driver เริ่มต้นชื่อ process Laravel จะเปิด child process ด้วย php artisan ต่อหนึ่งงาน แล้วส่งโค้ดของ closure ไปทาง environment variable
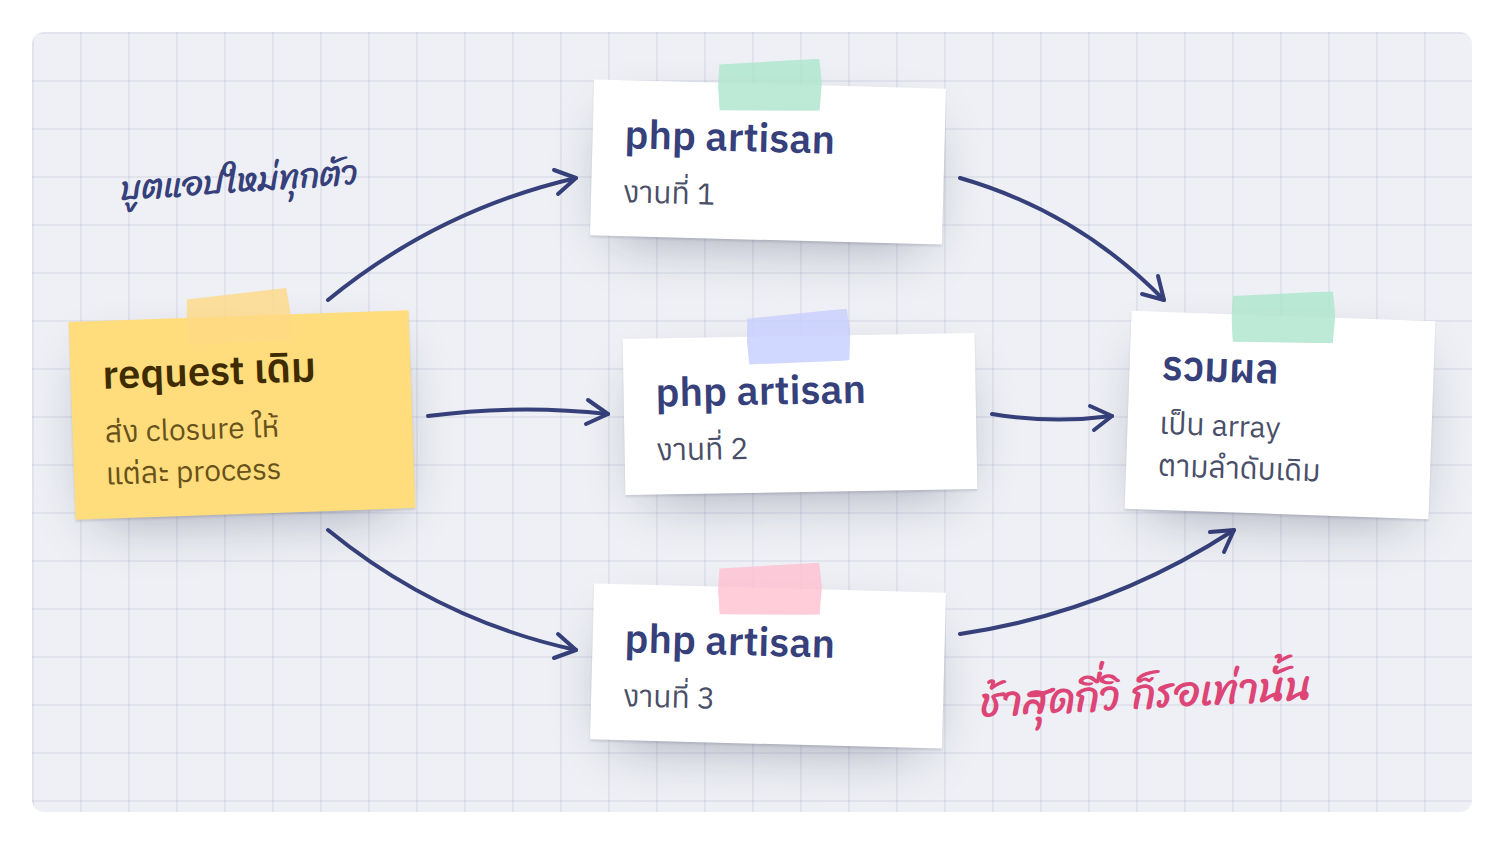
request เดิมรอจน child process ทุกตัวจบ แล้วค่อยได้ผลกลับมา
แต่ละ child บูต Laravel ใหม่ทั้งแอป รันงาน แล้วพิมพ์ผลออกทาง stdout ให้ตัวแม่อ่าน รูปแบบนี้มีผลตามมาหลายเรื่อง
| สิ่งที่เกิดขึ้น | ผลกับโค้ดของเรา |
|---|---|
| child บูตแอปใหม่ | เพิ่มเวลาราว 0.25 วินาที และใช้หน่วยความจำราว 45 MB ต่อตัว (วัดบนเครื่องพัฒนา ตัวเลขจริงขึ้นกับขนาดแอป) |
| child เป็นคำสั่ง console | auth()->check() เป็น false และไม่มี request เดิม ให้ส่ง user id เข้าไปเอง |
| child ต่อฐานข้อมูลของตัวเอง | มองไม่เห็นข้อมูลใน transaction ของตัวแม่ที่ยังไม่ commit |
| child อยู่นอก PHP-FPM | pm.max_children ไม่ได้นับ child เหล่านี้ |
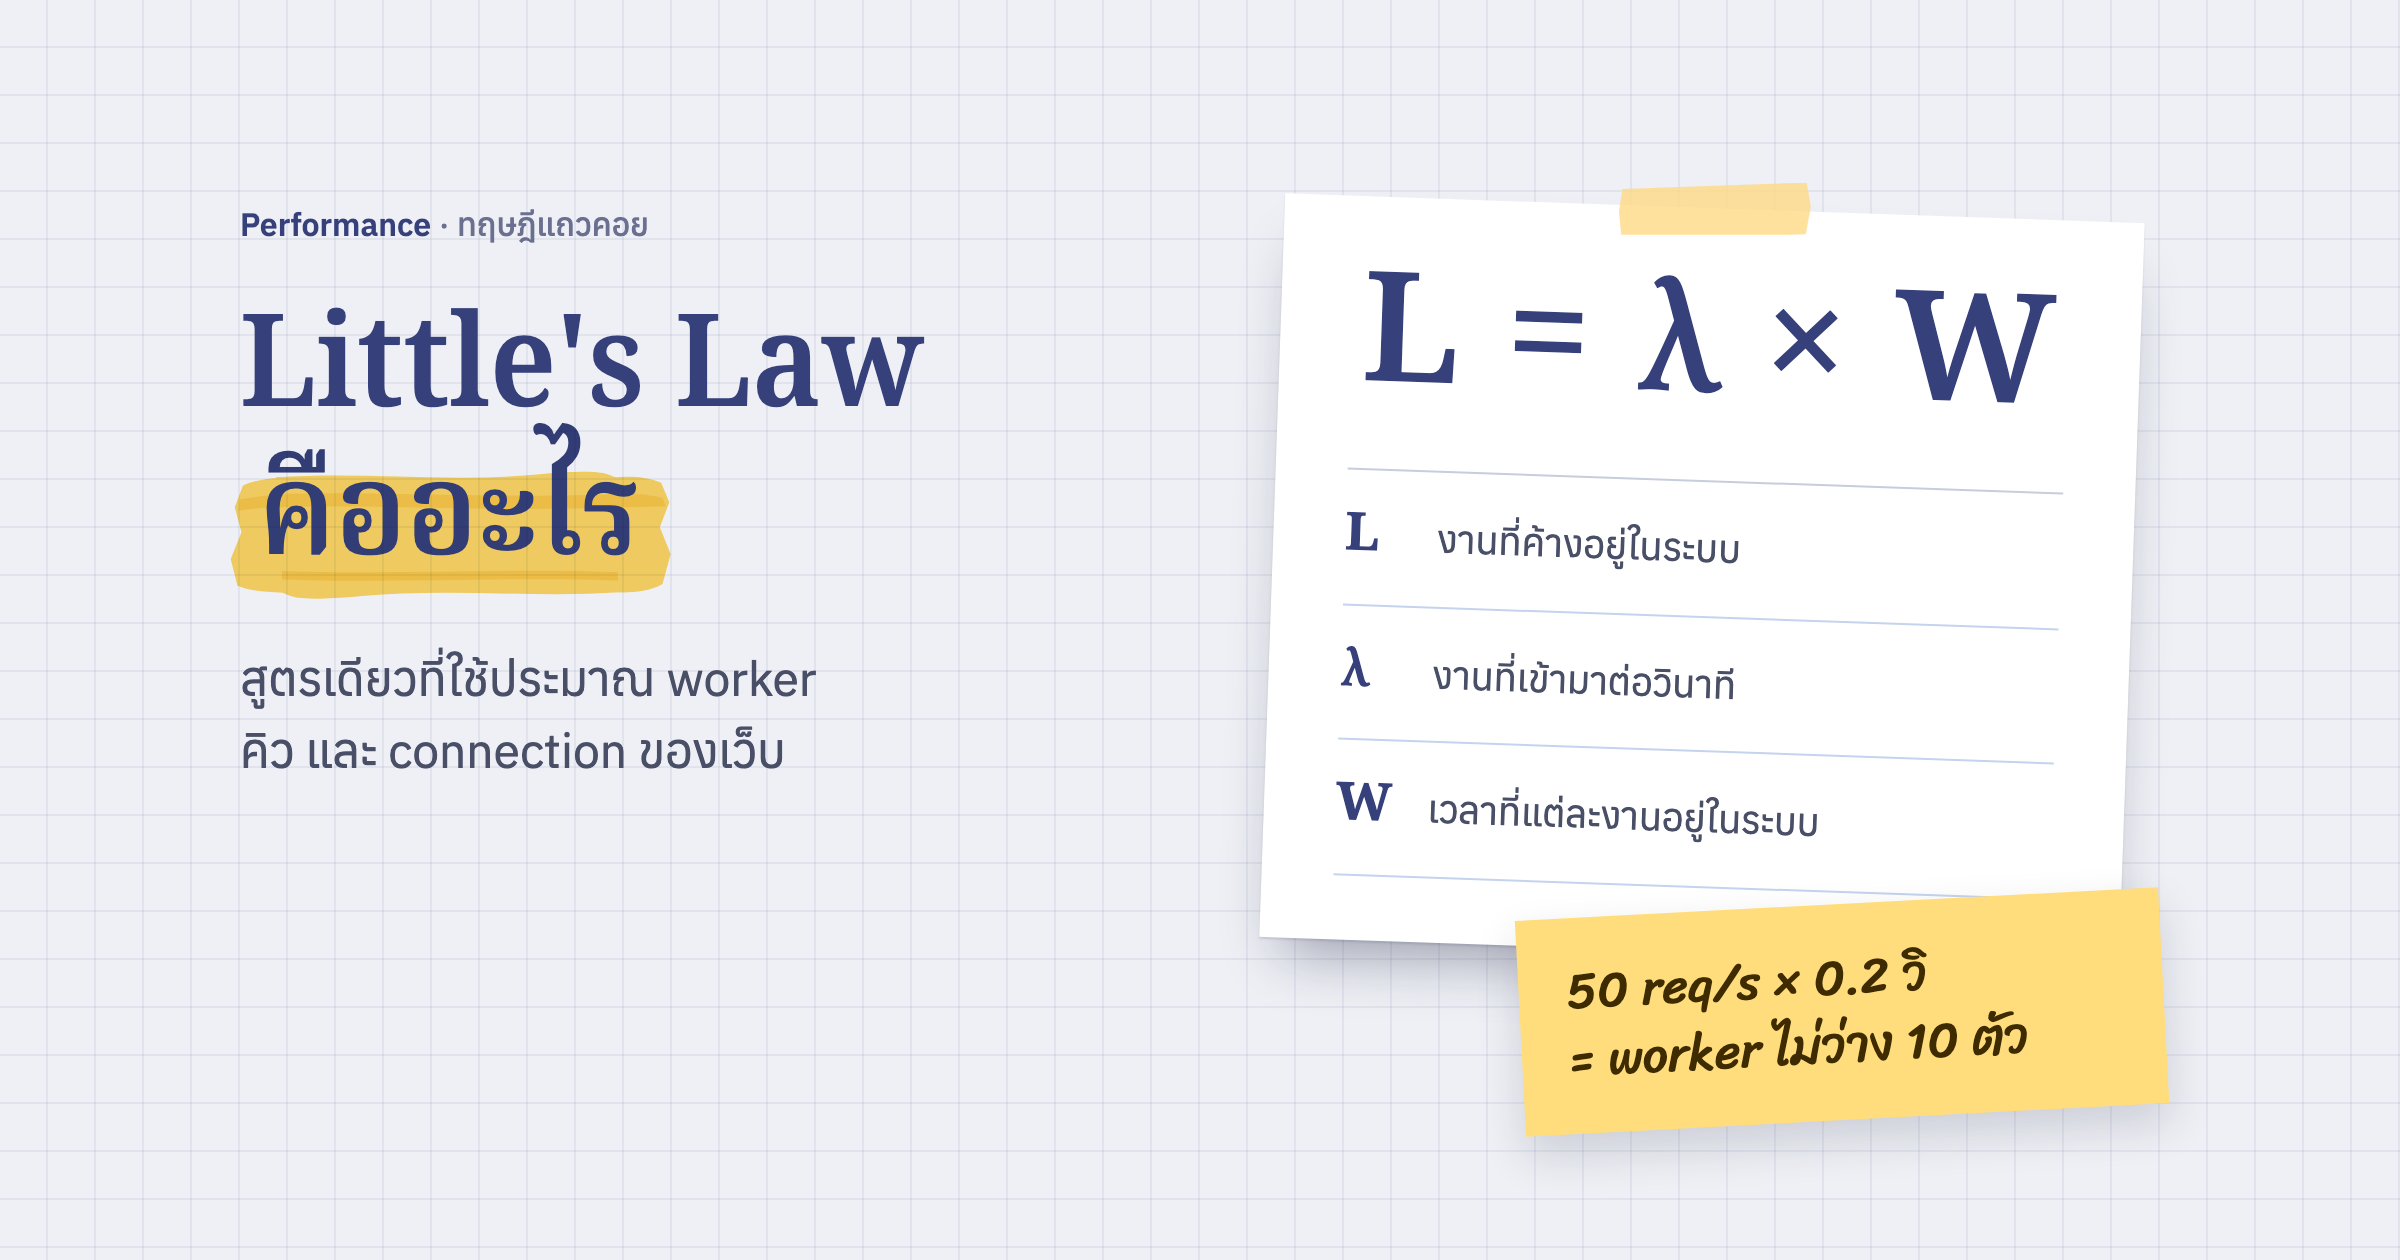
ข้อสุดท้ายสำคัญตอนคำนวณกำลังเครื่อง ถ้ามี 20 request พร้อมกัน และแต่ละ request แยก 3 งาน เครื่องจะมี PHP เพิ่มอีก 60 ตัว ใช้หน่วยความจำเพิ่มราว 2.7 GB และเปิด connection ฐานข้อมูลเพิ่มอีก 60 เส้น Little's Law ช่วยประมาณตัวเลขนี้จาก traffic จริงได้ครับ
ค่าที่ติดมาด้วยคือ Context เพราะ Laravel ส่งค่าใน Context ตามเข้าไปใน child ให้ด้วย
ถ้าใช้ shared hosting ให้เช็ค disable_functions ใน php.ini ก่อน เพราะ driver นี้ต้องใช้ proc_open ถ้าโฮสต์ปิดไว้ก็จะใช้ไม่ได้
Laravel มี driver ให้เลือกสามตัว
| driver | ทำงานยังไง | ใช้ตอนไหน |
|---|---|---|
process |
เปิด php artisan ต่องาน |
ค่าเริ่มต้น ใช้ได้ทั้งใน request และ console |
fork |
แตก process จากตัวปัจจุบันด้วย spatie/fork | คำสั่ง console หรือ job เท่านั้น ถ้าเรียกใน web request Laravel จะโยน exception |
sync |
รันทีละงานใน process เดิม ไม่ได้ขนานจริง | ตอนรัน test หรือปิดการแยก process ชั่วคราว |
fork เร็วกว่าเพราะไม่ต้องบูตแอปใหม่ แต่ต้องติดตั้งแพ็กเกจเพิ่ม และ child ต้องต่อฐานข้อมูลใหม่เอง
Concurrency::driver('fork')->run([...]);
เปลี่ยนค่าเริ่มต้นได้ด้วย CONCURRENCY_DRIVER ใน .env
งานที่ล้มเหลวทำให้ผลของงานอื่นหายไปด้วย
driver process รอทุกงานจบก่อน แล้วค่อยโยน exception ของงานที่ล้มเหลว ถ้างานแรกใช้ 2 วินาทีแล้วสำเร็จ แต่งานที่สองพังทันที เราจะรอครบ 2 วินาทีแล้วได้แค่ exception ไม่ได้ผลของงานแรกกลับมา ถ้าบางงานพังได้โดยไม่ต้องล้มทั้งหน้า ให้ try/catch ไว้ในตัวงานแล้วคืนค่าสำรอง
เรื่อง timeout ก็ควรตั้งเอง child แต่ละตัวมี timeout 60 วินาทีเป็นค่าเริ่มต้น ซึ่งนานเกินไปสำหรับหน้าเว็บที่คนกำลังรอ
Concurrency::run([...], timeout: 5);
งานที่ไม่ต้องใช้ผลลัพธ์ เรียก Concurrency::defer([...]) แทนได้ Laravel จะเริ่มงานหลังส่ง response ให้ผู้ใช้แล้ว แต่งานพวกนี้ไม่มี retry และไม่มี failed_jobs ให้ตามดู จึงเหมาะกับงานที่หายไปบ้างก็ไม่เป็นไร เช่นเก็บสถิติ
โค้ดแต่ละงานต้องอยู่คนละบรรทัด
ข้อนี้ไม่มีในเอกสาร และไม่มี error เตือน laravel/serializable-closure หาโค้ดของ closure จากเลขบรรทัดในไฟล์ ถ้าบรรทัดนั้นมีหลาย closure ก็จะหยิบตัวแรกเสมอ
// ผลที่ได้คือ ['first', 'first'] ทั้งสองงานรันโค้ดตัวแรก
Concurrency::run([fn () => 'first', fn () => 'second']);

// ผลที่ได้คือ ['first', 'second']
Concurrency::run([
    fn () => 'first',
    fn () => 'second',
]);
driver sync เรียก closure ตรง ๆ จึงให้ผลถูกต้อง ถ้า test ตั้ง driver เป็น sync ไว้ test จะผ่านทั้งที่บน production ได้ค่าผิด
ของที่ส่งเข้าออก child ต้อง serialize ได้
closure และผลลัพธ์เดินทางข้าม process จึงต้องแปลงเป็นข้อความได้ทั้งขาไปและขากลับ
- ส่งแค่ id ค่าที่ closure อ้างถึงจะเดินทางไปใน environment variable ซึ่งมีเพดาน Linux จำกัดข้อความหนึ่งก้อนไว้ 128 KB ถ้าส่ง array ใหญ่เกินไปจะเปิด process ไม่ขึ้น
- ระวังของที่ serialize ไม่ได้ อย่าง connection ฐานข้อมูลหรือ closure ใน closure ถ้าอ้างถึง
$thisใน job หรือ controller Laravel ต้อง serialize ทั้ง object นั้นไปด้วย - คืนค่าที่ serialize ได้ การคืน closure ออกมาจะพังตอนท้าย หลังงานรันเสร็จแล้ว
- อย่า
echoข้อมูลจากผู้ใช้ในงาน stdout คือช่องทางส่งผล และเคยเป็นช่องโหว่ RCE ที่แก้แล้วใน Laravel 13.40 กับ 12.71 ถ้าใช้ process driver ให้อัปเดตอย่างน้อยถึงรุ่นเหล่านี้
เลือกเครื่องมือตามชนิดของงาน
| งานที่ทำ | เครื่องมือที่เหมาะ |
|---|---|
| query หรืองานคำนวณหลายอย่าง และต้องใช้ผลใน request นี้ | Concurrency::run() |
| ยิง API หลายตัวพร้อมกัน | Http::pool() |
| ส่วนของหน้าเว็บที่โหลดทีหลังได้ | Inertia::defer() หรือ lazy load |
| งานนาน งานที่ต้อง retry หรือส่งอีเมล | Queue job |
| งานเล็กที่ทำหลังตอบ response และหายได้ | defer() |
Http::pool() น่าจะตรงกับงานส่วนใหญ่กว่าที่คิด เพราะการรอ API คือการรอ network ใช้ process เดียวก็รอพร้อมกันหลายเส้นได้ ไม่ต้องบูตแอปใหม่ และก่อนจะแยก query ก็ลองดู index กับการรวม query ก่อน เพราะแก้ตรงนั้นได้ผลโดยไม่เพิ่มภาระให้เครื่อง
ขนานได้มากขึ้นก็ยิ่งต้องจำกัดจำนวน
ระบบหลังบ้านตัวหนึ่งที่เราดูแลต้องเรียก API ของระบบปลายทางตัวเดียวผ่าน VPN เส้นเดียว ช่วงแรกงานดึงข้อมูลชุดหนึ่งเขียนด้วย Concurrency::driver('sync')->run([...]) รับข้อมูลห้าชุดกลับมาก่อน แล้วค่อยเปิด transaction บันทึกในตัวแม่ แม้ driver นี้ยังรันทีละงาน รูปแบบ "ดึงข้อมูลนอก transaction แล้วเขียนทีเดียว" ก็ยังดีอยู่ เพราะไม่ค้าง transaction ไว้ระหว่างรอ API ส่วนการเรียก API ที่ขนานจริงในระบบนี้ใช้ HTTP pool ใน queue job
เรื่องที่ต้องคิดคือตัวคูณ ถ้ามี 20 worker แต่ละตัวยิงพร้อมกัน 5 เส้น ปลายทางจะรับ 100 connection ทั้งที่ค่าที่ตั้งไว้ใน job บอกแค่ 5 เราจึงต้องมีตัวจำกัดสองชั้น ตามแนวเดียวกับเรื่องตั้ง retry ไม่ให้ซ้ำเติมปลายทาง
- จำกัดต่องาน ให้
Http::pool(..., concurrency: 5)ปล่อยเส้นใหม่ทันทีที่เส้นเก่าจบ เส้นที่ค้างเส้นเดียวจึงไม่ทำให้ทั้งชุดรอ - จำกัดรวมทั้งระบบ ใช้ตัวนับกลางใน Redis ที่ทุก worker ต้องขอสิทธิ์ก่อนยิง ระบบนี้ตั้งไว้ 15 เส้น และกันไว้ 3 เส้นให้งานที่มีผู้ใช้รออยู่ งานเบื้องหลังจึงไม่กินจนหมด Laravel มี
Cache::funnel()(เอกสาร) สำหรับจำกัดแบบนี้ให้แล้ว
ตัวเลขเหล่านี้มาจากปลายทางของระบบนั้น ระบบอื่นต้องดูจากว่าปลายทางรับได้เท่าไหร่ การใช้ Concurrency::run() ก็เหมือนกัน ทุกงานที่แยกออกไปไปรวมกันที่ฐานข้อมูลหรือ API ตัวเดิม จึงควรคิดตัวเลขรวมทั้งระบบก่อนเปิดใช้งานจริงครับ